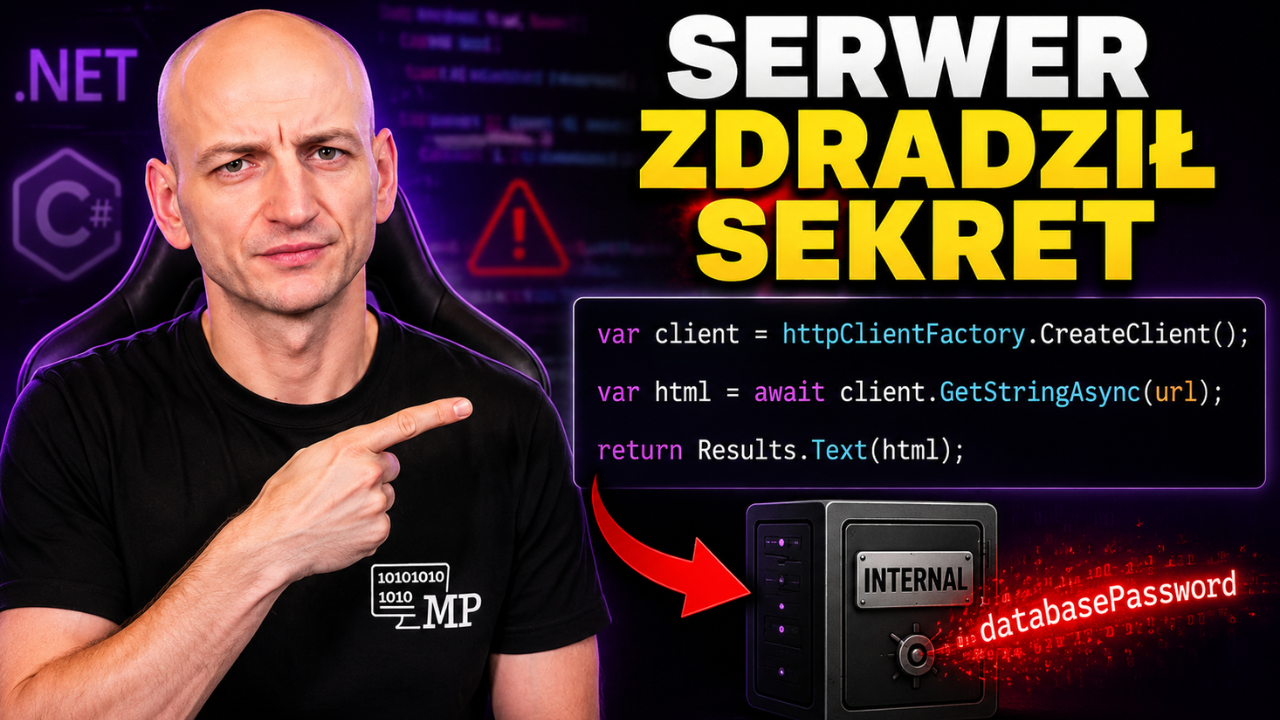
Za chwilę zobaczysz 3 linijki kodu, które wyglądają całkowicie normalnie. Nie ma w nich dynamicznego SQL-a ani podejrzanej biblioteki - jest zwykły HttpClient, którego prawdopodobnie używasz w swoich aplikacjach. A jednak dzięki tym 3 linijkom atakujący może zmusić Twój serwer do połączenia się z usługą wewnętrzną i odczytać dane, których nigdy nie chciałeś wystawiać użytkownikom. Najgorsze jest to, że ten kod działa dokładnie tak, jak zaplanował programista.
Ta podatność nazywa się SSRF (Server-Side Request Forgery) i rzadko siedzi w podejrzanych zakamarkach aplikacji. Najczęściej ukrywa się w zupełnie zwyczajnych funkcjach biznesowych: podglądzie linku, pobieraniu zdjęcia z adresu URL, imporcie pliku czy testowaniu webhooka. Wszędzie tam, gdzie użytkownik podaje adres, a serwer posłusznie pod niego idzie.
W tym artykule najpierw przeprowadzimy atak na lokalnej aplikacji demonstracyjnej, a dopiero potem przeanalizujemy kod. Zobaczysz, dlaczego 4 popularne "poprawki" (blokowanie localhost, StartsWith, samo HTTPS i sprawdzanie tylko pierwszego adresu) da się obejść. Następnie krok po kroku zbudujemy bezpieczne rozwiązanie w ASP.NET Core: stały adres w typowanym kliencie, allowlistę hostów z walidatorem URL, bezpiecznie skonfigurowany HttpClient, limit rozmiaru odpowiedzi i testy prób obejścia. Na koniec dostaniesz checklistę 11 pytań, z którą przejdziesz przez swój projekt.
Wersje .NET: cały kod z artykułu działa w .NET 8 i nowszych (w tym w .NET 10) - korzysta z minimal API i składni C# 12. Wszystkie przykłady uruchamiamy wyłącznie lokalnie, na fikcyjnych sekretach. Nie testuj takich ataków na cudzych serwisach ani na prawdziwej infrastrukturze.
Środowisko demo: publiczne API i usługa wewnętrzna
Do demonstracji wystarczą 2 zwykłe aplikacje ASP.NET Core w jednym rozwiązaniu (SsrfDemo):
• PublicApi - publiczne API pod adresem http://localhost:5100. Użytkownik może wysyłać do niego żądania.
• InternalService - usługa symulująca system wewnętrzny, dostępna pod adresem loopback serwera http://127.0.0.1:5101.
• PublicApi.Tests - projekt z testami, do którego wrócimy na końcu.
Przepływ wygląda tak: użytkownik → PublicApi → InternalService. Użytkownik rozmawia tylko z publicznym API, a usługa wewnętrzna jest osiągalna wyłącznie z serwera. W produkcji taka usługa mogłaby działać na serwerze aplikacji albo w sieci wewnętrznej - jako panel administracyjny, system płatności, serwis raportowy albo endpoint diagnostyczny. Zdalny użytkownik nie połączy się z adresem loopback serwera. Może jednak spróbować przekonać publiczne API, żeby zrobiło to za niego.
Obie aplikacje uruchomisz w 2 terminalach:
dotnet run --project src/InternalService
dotnet run --project src/PublicApi
albo w Visual Studio: prawy przycisk na rozwiązaniu → Configure Startup Projects → Multiple startup projects → Start dla InternalService i PublicApi.
Usługa wewnętrzna. InternalService ma 1 prosty endpoint, który zwraca fikcyjne hasło do bazy danych i fikcyjny klucz API:
var builder = WebApplication.CreateBuilder(args);
var app = builder.Build();

app.MapGet("/internal/secrets", () => Results.Ok(new
{
    databasePassword = "Demo-Prod-Password-2026!",
    paymentApiKey = "demo_sk_internal_51ABCDEF",
    message = "Tego endpointu nie powinien wywołać użytkownik PublicApi."
}));

app.Run();
Oczywiście w prawdziwym systemie nie zwracamy sekretów w ten sposób - tutaj chodzi wyłącznie o pokazanie skutków podatności. W realnej aplikacji atakujący mógłby w ten sposób dotrzeć do endpointów diagnostycznych, danych użytkowników, informacji o konfiguracji albo funkcji administracyjnych.
Najważniejszy jest adres, na którym nasłuchuje usługa. W Properties/launchSettings.json ustawiamy 127.0.0.1:
{
  "profiles": {
    "InternalService": {
      "commandName": "Project",
      "launchBrowser": false,
      "applicationUrl": "http://127.0.0.1:5101",
      "environmentVariables": {
        "ASPNETCORE_ENVIRONMENT": "Development"
      }
    }
  }
}
Usługa nasłuchuje wyłącznie lokalnie. To symuluje zasób, który jest osiągalny z procesu serwera, ale nie powinien być osiągalny dla użytkownika publicznej aplikacji.
Podatny endpoint: podgląd adresu URL
Publiczne API ma funkcję podglądu adresu. Użytkownik przekazuje URL, aplikacja pobiera jego zawartość i zwraca wynik:
builder.Services.AddHttpClient("unsafe"); /* zwykły klient z domyślnymi ustawieniami */

var app = builder.Build();

app.MapGet("/api/vulnerable/preview", async (
    string url,
    IHttpClientFactory httpClientFactory,
    CancellationToken cancellationToken) =>
{
    var client = httpClientFactory.CreateClient("unsafe");
    var response = await client.GetStringAsync(url, cancellationToken);
    return Results.Text(response, "application/json");
});
Taka funkcja w różnych odmianach pojawia się w bardzo wielu aplikacjach, np. przy:
• generowaniu podglądu strony,
• pobieraniu zdjęcia z adresu URL,
• importowaniu dokumentu,
• testowaniu webhooka,
• generowaniu pliku PDF,
• sprawdzaniu, czy wskazana usługa działa.
Kod jest krótki i na pierwszy rzut oka wygląda poprawnie. Zanim zaczniesz szukać w nim błędu, zobacz, co da się z nim zrobić.
Atak: odczytujemy sekrety z usługi wewnętrznej
Atakujący nie musi robić niczego wyrafinowanego. Wystarczy, że jako parametr url poda adres usługi wewnętrznej. W PowerShellu najpierw kodujemy adres, a potem wywołujemy publiczne API:
$target = [uri]::EscapeDataString("http://127.0.0.1:5101/internal/secrets")

Invoke-RestMethod "http://localhost:5100/api/vulnerable/preview?url=$target"
Ten sam efekt uzyskasz w przeglądarce, Postmanie czy Insomnii, wywołując adres http://localhost:5100/api/vulnerable/preview?url=http%3A%2F%2F127.0.0.1%3A5101%2Finternal%2Fsecrets. Odpowiedź:
{
  "databasePassword": "Demo-Prod-Password-2026!",
  "paymentApiKey": "demo_sk_internal_51ABCDEF",
  "message": "Tego endpointu nie powinien wywołać użytkownik PublicApi."
}
Właśnie odczytaliśmy dane z usługi wewnętrznej (demonstracyjne, w lokalnym środowisku testowym). Zwróć uwagę, co się wydarzyło. Użytkownik nie połączył się z usługą bezpośrednio - wysłał jedynie adres do publicznego API. To publiczne API wykonało żądanie do własnego adresu loopback i odesłało odpowiedź użytkownikowi. Nasza aplikacja stała się pośrednikiem atakującego.
Te 3 linijki, czyli czym jest SSRF
Wróćmy do kodu. Oto tytułowe 3 linijki:
var client = httpClientFactory.CreateClient("unsafe");
var response = await client.GetStringAsync(url, cancellationToken);
return Results.Text(response, "application/json");
Tworzymy klienta HTTP. Pobieramy adres przekazany przez użytkownika. Zwracamy pobraną zawartość. Sam HttpClient nie jest tu problemem. Problemem jest to, że użytkownik kontroluje miejsce, z którym połączy się nasz serwer.
Ta podatność nazywa się SSRF, czyli Server-Side Request Forgery (fałszowanie żądań po stronie serwera). Jej mechanizm najłatwiej opisać jednym zdaniem: użytkownik wybiera cel, a serwer wykonuje żądanie.
W normalnej sytuacji użytkownik komunikuje się tylko z publicznym API. Przy SSRF użytkownik przekazuje adres, ale żądanie wykonuje serwer - z własnej sieci i z własnego środowiska. To oznacza, że atakujący może próbować dotrzeć do zasobów, które są dostępne dla aplikacji, ale nie są dostępne dla niego bezpośrednio:
• localhost i adres loopback serwera,
• prywatne adresy IP w sieci firmowej,
• nazwy usług w sieci wewnętrznej,
• specjalne endpointy infrastruktury chmurowej (np. usługa metadanych instancji pod adresem 169.254.169.254 w AWS i Azure).
Serwer staje się wtedy czymś w rodzaju proxy sterowanego przez atakującego.
Gdzie w aplikacji szukać SSRF?
SSRF nie pojawia się wyłącznie w podejrzanych fragmentach aplikacji. Najczęściej ukrywa się w całkowicie normalnych funkcjach biznesowych. Sprawdź szczególnie:
• pobieranie obrazów z URL,
• importowanie plików,
• generowanie podglądu strony,
• testowanie webhooków,
• generowanie PDF,
• integracje z zewnętrznymi API,
• sprawdzanie dostępności adresu,
• pobieranie avatarów i załączników.
Najbardziej niebezpieczne są miejsca, w których użytkownik może przekazać pełny adres URL. I uwaga na częstą pułapkę myślenia: to, że adres "ma być publiczny", nie oznacza jeszcze, że użytkownik rzeczywiście przekaże adres publiczny. Z punktu widzenia aplikacji http://127.0.0.1 też jest poprawnym adresem URL.
Co może zrobić atakujący?
Skutki SSRF zależą od infrastruktury. Czasami atakujący odczyta tylko nazwę wewnętrznego serwera. Czasami znajdzie panel administracyjny bez dodatkowego uwierzytelnienia. Zagrożenia można podzielić na 4 grupy:
• Usługi wewnętrzne. Dostęp do paneli administracyjnych, wewnętrznych API, monitoringu i diagnostyki.
• Skanowanie sieci. Sprawdzanie, które hosty i porty odpowiadają. Nawet jeśli aplikacja nie zwraca treści, atakujący może wyciągać wnioski z samego czasu odpowiedzi.
• Dane infrastruktury. Konfiguracja, tokeny i metadane środowiska. W chmurze szczególnie niebezpieczne są lokalne endpointy zwracające metadane albo dane uwierzytelniające.
• Wykonywanie operacji. Wywoływanie endpointów, które miały być dostępne tylko wewnętrznie.
Jeżeli podatna funkcja pozwala dodatkowo ustawić metodę HTTP, nagłówki albo treść żądania, konsekwencje mogą być jeszcze poważniejsze.
4 popularne poprawki, które nie wystarczają
Być może już wiesz, jak poprawić ten kod. Problem w tym, że najpopularniejsze poprawki nadal można obejść. Wyglądają jak zabezpieczenie, ale nim nie są.
Poprawka 1: blokowanie słowa localhost. Pierwszy pomysł, który przychodzi do głowy:
if (url.Contains("localhost"))
{
    return Results.BadRequest();
}
Problem w tym, że lokalny serwer można wskazać na wiele sposobów:
• http://localhost:5101
• http://127.0.0.1:5101
• http://[::1]:5101
Możemy użyć nazwy localhost, adresu IPv4, adresu IPv6, innej nazwy hosta albo innego zapisu prowadzącego do tego samego miejsca. Filtrowanie pojedynczych napisów nie rozwiązuje problemu.
Poprawka 2: StartsWith. Kolejny pomysł: sprawdzamy, czy adres zaczyna się od zaufanej domeny.
if (!url.StartsWith("https://example.com"))
{
    return Results.BadRequest();
}
To również jest niebezpieczne, bo URL nie powinien być analizowany jak zwykły tekst. Oba poniższe adresy przejdą ten test:
• https://example.com.evil.test
• https://example.com@evil.test
Pierwszy prowadzi do domeny example.com.evil.test, czyli zupełnie innej niż example.com. W drugim example.com w ogóle nie jest hostem, tylko danymi użytkownika (wszystko przed znakiem @) - prawdziwym hostem jest evil.test. Dlatego URL trzeba najpierw sparsować, a dopiero potem sprawdzać jego konkretne elementy.
Poprawka 3: tylko HTTPS. Skoro parsujemy adres, może wystarczy wymusić bezpieczny protokół?
if (uri.Scheme != Uri.UriSchemeHttps)
{
    return Results.BadRequest();
}
HTTPS szyfruje komunikację, ale nie gwarantuje, że łączymy się z właściwym serwerem. Wewnętrzna usługa również może korzystać z HTTPS. Samo wymuszenie protokołu nie zatrzymuje SSRF.
Poprawka 4: sprawdzenie tylko pierwszego adresu. Załóżmy, że poprawnie zwalidowaliśmy adres podany przez użytkownika. Zaufany serwer może jednak zwrócić przekierowanie (np. przez lukę typu open redirect). Użytkownik podaje https://trusted.example, adres przechodzi walidację, a serwer odpowiada 302 Redirect z nagłówkiem Location wskazującym np. https://127.0.0.1/admin.
Jeżeli HttpClient automatycznie podąży za przekierowaniem (a domyślnie to robi), kolejne żądanie zostanie wykonane pod zupełnie inny adres - taki, którego nikt nie sprawdzał. Drobny szczegół: .NET nie podąża automatycznie za przekierowaniem z HTTPS na HTTP, ale przekierowanie HTTPS → HTTPS albo HTTP → HTTP przejdzie bez przeszkód. Dlatego przy takich funkcjach trzeba wyłączyć automatyczne przekierowania albo walidować każdy kolejny adres.
Najlepsza obrona: nie pozwalaj użytkownikowi wybierać hosta
Zanim zaczniesz budować skomplikowany walidator, zadaj najważniejsze pytanie: czy użytkownik naprawdę musi podawać cały URL?
W wielu przypadkach odpowiedź brzmi: nie. Jeżeli aplikacja zawsze łączy się z jednym zewnętrznym systemem, adres hosta powinien znajdować się w konfiguracji. Użytkownik może przekazywać identyfikator produktu, numer zamówienia albo względną ścieżkę, ale nie powinien wybierać serwera.
W praktyce najprościej zrobić to typowanym klientem HTTP ze stałym BaseAddress:
builder.Services.AddHttpClient<CatalogClient>(client =>
{
    client.BaseAddress = new Uri("https://catalog.example.com/");
    client.Timeout = TimeSpan.FromSeconds(5);
});
Klient udostępnia konkretną operację biznesową:
public sealed class CatalogClient
{
    private readonly HttpClient _httpClient;

    public CatalogClient(HttpClient httpClient)
    {
        _httpClient = httpClient;
    }

    public async Task<string> GetProductAsync(
        int productId,
        CancellationToken cancellationToken)
    {
        return await _httpClient.GetStringAsync(
            $"products/{productId}",
            cancellationToken);
    }
}
A endpoint przyjmuje od użytkownika tylko identyfikator:
app.MapGet("/api/products/{id:int}", async (
    int id,
    CatalogClient catalogClient,
    CancellationToken cancellationToken) =>
{
    var result = await catalogClient.GetProductAsync(
        id,
        cancellationToken);

    return Results.Text(result);
});
Tutaj użytkownik przekazuje wyłącznie identyfikator produktu (dodatkowo ograniczony do liczby całkowitej przez {id:int}). Nie kontroluje protokołu, hosta ani portu - adres zewnętrznego systemu ustawiamy my (w prawdziwym projekcie najlepiej w appsettings.json). Do tego typowany klient udostępnia konkretną operację biznesową zamiast ogólnej metody przyjmującej dowolny URL.
To rozwiązanie jest prostsze i znacznie bezpieczniejsze niż próba filtrowania wszystkich możliwych adresów.
Gdy pełny URL jest naprawdę potrzebny: allowlista hostów
Czasami pełny URL rzeczywiście jest częścią funkcji. Przykładem może być importer danych z kilku zatwierdzonych serwisów. Wtedy stosujemy ścisłą allowlistę: zamiast zgadywać, które adresy są złe, definiujemy konkretne hosty, z którymi aplikacja ma prawo się łączyć.
Listę hostów i limit rozmiaru odpowiedzi trzymamy w appsettings.json:
{
  "UrlSafety": {
    "AllowedHosts": [
      "example.com",
      "www.example.com"
    ],
    "MaxResponseBytes": 1000000
  }
}
Do tego model opcji:
public sealed class UrlSafetyOptions
{
    public string[] AllowedHosts { get; init; } = [];
    public int MaxResponseBytes { get; init; } = 1_000_000;
}
i rejestracja w Program.cs:
builder.Services.Configure<UrlSafetyOptions>(
    builder.Configuration.GetSection("UrlSafety"));

builder.Services.AddSingleton<SafeUrlValidator>();
Sercem tego rozwiązania jest SafeUrlValidator, któremu przyjrzymy się teraz dokładnie.
Walidacja adresu URL krok po kroku
Walidator zwraca prosty wynik: informację, czy adres jest poprawny, sparsowany obiekt Uri albo komunikat błędu:
public sealed record UrlValidationResult(
    bool IsValid,
    Uri? Uri,
    string? Error)
{
    public static UrlValidationResult Success(Uri uri) =>
        new(true, uri, null);

    public static UrlValidationResult Failure(string error) =>
        new(false, null, error);
}
A tak wygląda sam walidator:
using Microsoft.Extensions.Options;

public sealed class SafeUrlValidator
{
    private readonly HashSet<string> _allowedHosts;

    public SafeUrlValidator(IOptions<UrlSafetyOptions> options)
    {
        _allowedHosts = options.Value.AllowedHosts
            .Select(host => host.Trim().TrimEnd('.'))
            .ToHashSet(StringComparer.OrdinalIgnoreCase);
    }

    public UrlValidationResult Validate(string input)
    {
        /* Krok 1: parsowanie */
        if (!Uri.TryCreate(input, UriKind.Absolute, out var uri))
        {
            return UrlValidationResult.Failure(
                "URL nie jest poprawnym adresem absolutnym.");
        }

        /* Krok 2: protokół */
        if (!string.Equals(
            uri.Scheme,
            Uri.UriSchemeHttps,
            StringComparison.OrdinalIgnoreCase))
        {
            return UrlValidationResult.Failure(
                "Dozwolony jest wyłącznie protokół HTTPS.");
        }

        /* Krok 3: dane użytkownika */
        if (!string.IsNullOrWhiteSpace(uri.UserInfo))
        {
            return UrlValidationResult.Failure(
                "URL nie może zawierać danych użytkownika.");
        }

        /* Krok 4: dokładny host */
        var host = uri.IdnHost.TrimEnd('.');

        if (!_allowedHosts.Contains(host))
        {
            return UrlValidationResult.Failure(
                $"Host '{host}' nie znajduje się na allowliście.");
        }

        /* Krok 5: port */
        if (!uri.IsDefaultPort)
        {
            return UrlValidationResult.Failure(
                "Niestandardowy port nie jest dozwolony.");
        }

        return UrlValidationResult.Success(uri);
    }
}
Przejdźmy przez niego krok po kroku.
Krok 1: poprawne parsowanie. Uri.TryCreate(input, UriKind.Absolute, out var uri) - nie analizujemy adresu za pomocą Split, wyrażeń regularnych ani StartsWith. Używamy parsera URL wbudowanego w .NET, który rozbija adres na protokół, dane użytkownika, host, port i ścieżkę. Później do HttpClient przekażemy dokładnie ten sam, już sprawdzony obiekt Uri.
Krok 2: protokół. Sprawdzamy uri.Scheme i w tym konkretnym przypadku akceptujemy wyłącznie HTTPS. Jak już wiesz, nie jest to pełne zabezpieczenie przed SSRF, ale to 1 z warstw ochronnych.
Krok 3: dane użytkownika. Odrzucamy adresy, w których uri.UserInfo nie jest puste. Dzięki temu nie przejdzie konstrukcja w stylu example.com@evil.test.
Krok 4: dokładny host. _allowedHosts.Contains(host) porównuje host w całości. Nie sprawdzamy, czy adres zawiera nazwę domeny, nie używamy StartsWith ani prostego EndsWith (evilexample.com też kończy się na "example.com"). example.com.evil.test to po prostu nie jest ten sam host co example.com. Przy okazji 2 szczegóły: IdnHost zwraca host w postaci używanej przez DNS (domeny z polskimi znakami są zamieniane na zapis punycode), a TrimEnd('.') ucina kropkę na końcu, bo example.com. to w DNS ta sama domena co example.com. W konstruktorze w ten sam sposób ucinamy spacje i końcową kropkę z wpisów allowlisty.
Krok 5: port. Sprawdzamy uri.IsDefaultPort. Jeżeli integracja zawsze korzysta ze standardowego portu HTTPS, nie ma powodu pozwalać użytkownikowi na wskazanie dowolnego portu. Każda dodatkowa możliwość zwiększa powierzchnię ataku.
Bezpieczniejsza konfiguracja HttpClient
Walidacja adresu to dopiero pierwsza warstwa. Druga to sam klient HTTP, przez który wychodzą żądania do adresów od użytkownika. Rejestrujemy go jako osobnego, nazwanego klienta "safe":
using System.Net;

builder.Services
    .AddHttpClient("safe", client =>
    {
        client.Timeout = TimeSpan.FromSeconds(5);
        client.DefaultRequestHeaders.UserAgent.ParseAdd("SsrfDemo/1.0");
    })
    .ConfigurePrimaryHttpMessageHandler(() =>
        new SocketsHttpHandler
        {
            AllowAutoRedirect = false,
            UseCookies = false,
            AutomaticDecompression =
                DecompressionMethods.GZip |
                DecompressionMethods.Deflate
        });
Co tu się dzieje:
• AllowAutoRedirect = false - wyłączamy automatyczne przekierowania, więc odpowiedź 3xx trafi do naszego kodu, zamiast prowadzić klienta pod nowy, niesprawdzony adres.
• Timeout = 5 sekund - krótki timeout, żeby wolny albo celowo "zawieszony" serwer nie blokował zasobów aplikacji.
• UseCookies = false - wyłączamy automatyczne używanie cookies.
• własny User-Agent - żądania z tej funkcji łatwo rozpoznać w logach.
Do tego zasada, której nie ustawisz w konfiguracji: nie kopiuj bezmyślnie do takiego żądania nagłówka Authorization, tokenów użytkownika ani innych wrażliwych nagłówków. Im bardziej ogólna jest funkcja pobierania adresu, tym większa powinna być ostrożność.
Zabezpieczony endpoint: kilka niezależnych warstw
Teraz złóżmy wszystko w całość. Nadal przyjmujemy adres URL od użytkownika, ale tym razem nie przekazujemy go od razu do HttpClient:
using Microsoft.Extensions.Options; /* na początku Program.cs */

app.MapGet("/api/secure/preview", async (
    string url,
    SafeUrlValidator validator,
    IHttpClientFactory httpClientFactory,
    IOptions<UrlSafetyOptions> options,
    CancellationToken cancellationToken) =>
{
    /* 1. walidacja adresu, zanim cokolwiek wyślemy */
    var validation = validator.Validate(url);

    if (!validation.IsValid)
    {
        return Results.BadRequest(new { error = validation.Error });
    }

    /* 2. żądanie ze sprawdzonego obiektu Uri, nie z surowego tekstu */
    using var request = new HttpRequestMessage(
        HttpMethod.Get,
        validation.Uri);

    /* 3. klient bez przekierowań i cookies, z timeoutem */
    var client = httpClientFactory.CreateClient("safe");

    /* 4. najpierw tylko nagłówki */
    using var response = await client.SendAsync(
        request,
        HttpCompletionOption.ResponseHeadersRead,
        cancellationToken);

    /* 5. przekierowanie = nowy, niesprawdzony adres */
    if ((int)response.StatusCode is >= 300 and < 400)
    {
        return Results.BadRequest(new
        {
            error = "Przekierowania są wyłączone. Każdy adres docelowy musi przejść osobną walidację."
        });
    }

    /* 6. błędy HTTP (404, 401, 500...) */
    if (!response.IsSuccessStatusCode)
    {
        return Results.StatusCode((int)response.StatusCode);
    }

    /* 7. odczyt treści tylko do limitu */
    try
    {
        var body = await LimitedResponseReader.ReadAsUtf8StringAsync(
            response.Content,
            options.Value.MaxResponseBytes,
            cancellationToken);

        return Results.Text(body, "text/plain");
    }
    catch (ResponseTooLargeException exception)
    {
        return Results.Problem(
            title: "Odpowiedź jest zbyt duża",
            detail: exception.Message,
            statusCode: StatusCodes.Status413PayloadTooLarge);
    }
});
Prześledźmy, co się dzieje po kolei:
1. Walidacja. Najpierw uruchamiamy walidator, który sprawdza m.in. protokół, host, port i allowlistę. Jeżeli adres nie przejdzie walidacji, od razu zwracamy 400 Bad Request. Nie chcemy nawet próbować połączenia z adresem, którego wcześniej nie uznaliśmy za bezpieczny.
2. Żądanie ze sprawdzonego Uri. HttpRequestMessage tworzymy z validation.Uri, czyli z już sparsowanego i sprawdzonego obiektu, a nie z surowego tekstu od użytkownika.
3. Klient "safe". Pobieramy wcześniej skonfigurowanego klienta z timeoutem, wyłączonymi cookies i - przede wszystkim - wyłączonymi przekierowaniami.
4. ResponseHeadersRead. Dzięki tej opcji HttpClient nie pobiera od razu całej odpowiedzi do pamięci. Najpierw dostajemy nagłówki i możemy zdecydować, czy w ogóle chcemy czytać treść.
5. Przekierowania. Ponieważ automatyczne przekierowania są wyłączone, odpowiedź 3xx trafia bezpośrednio do naszego kodu i nie podążamy za nią. To ważne, bo zaufany adres mógłby przekierować nas na localhost, prywatny adres IP albo usługę wewnętrzną. Zwracamy błąd z informacją, że każdy kolejny adres musiałby przejść osobną walidację.
6. Błędy HTTP. Jeżeli zewnętrzny serwer zwróci np. 404, 401 albo 500, nie próbujemy czytać odpowiedzi jak poprawnych danych, tylko zwracamy ten sam kod statusu.
7. Limit rozmiaru. Zamiast prostego ReadAsStringAsync korzystamy z własnego czytnika, który odczytuje odpowiedź tylko do limitu z konfiguracji (MaxResponseBytes). Zewnętrzny serwer mógłby przecież zwrócić ogromną odpowiedź i zająć całą pamięć. Po przekroczeniu limitu czytnik rzuca ResponseTooLargeException, a my zwracamy 413 Payload Too Large. Nie ukrywamy problemu jako zwykłego błędu serwera, tylko jasno informujemy, że odpowiedź była większa niż dozwolony limit.
Czytnik z limitem rozmiaru. LimitedResponseReader nie jest częścią .NET - to nasza klasa. Przykładowa implementacja może wyglądać tak:
using System.Text;

public sealed class ResponseTooLargeException : Exception
{
    public ResponseTooLargeException(int maxBytes)
        : base($"Odpowiedź przekracza limit {maxBytes} bajtów.")
    {
    }
}

public static class LimitedResponseReader
{
    public static async Task<string> ReadAsUtf8StringAsync(
        HttpContent content,
        int maxBytes,
        CancellationToken cancellationToken)
    {
        /* szybka odmowa, jeśli serwer sam deklaruje zbyt dużą odpowiedź */
        if (content.Headers.ContentLength > maxBytes)
        {
            throw new ResponseTooLargeException(maxBytes);
        }

        await using var stream = await content.ReadAsStreamAsync(cancellationToken);
        using var buffer = new MemoryStream();
        var chunk = new byte[8192];
        int read;

        /* Content-Length może kłamać albo go nie być, więc liczymy bajty sami */
        while ((read = await stream.ReadAsync(chunk, cancellationToken)) > 0)
        {
            if (buffer.Length + read > maxBytes)
            {
                throw new ResponseTooLargeException(maxBytes);
            }

            buffer.Write(chunk, 0, read);
        }

        return Encoding.UTF8.GetString(buffer.GetBuffer(), 0, (int)buffer.Length);
    }
}
Czytamy strumień małymi porcjami i sami liczymy bajty, zamiast ufać nagłówkowi Content-Length (serwer może go nie wysłać albo podać nieprawdę). Limit dotyczy danych już po dekompresji, więc chroni też przed małą, mocno skompresowaną odpowiedzią, która po rozpakowaniu zajęłaby ogromną ilość pamięci.
W tym endpoincie mamy więc kilka niezależnych warstw ochrony: walidację adresu, blokadę automatycznych przekierowań, sprawdzenie kodu odpowiedzi, limit rozmiaru treści, timeout i obsługę anulowania żądania. To nadal nie oznacza, że każda funkcja przyjmująca dowolny URL jest bezpieczna - najlepiej wciąż jest nie pozwalać użytkownikowi wybierać hosta, jeżeli nie jest to konieczne. Ale jeżeli pełny URL rzeczywiście musi być częścią funkcji, takie warstwy znacząco ograniczają ryzyko SSRF i nadużycia zasobów serwera.
Próba ataku na zabezpieczony endpoint
Powtórzmy atak, tym razem na nowy endpoint:
$target = [uri]::EscapeDataString("http://127.0.0.1:5101/internal/secrets")

Invoke-RestMethod "http://localhost:5100/api/secure/preview?url=$target"
API odpowiada statusem 400 Bad Request (PowerShell pokaże to jako błąd) i treścią:
{
  "error": "Dozwolony jest wyłącznie protokół HTTPS."
}
Atakujący zmienia więc protokół na HTTPS:
$target = [uri]::EscapeDataString("https://127.0.0.1:5101/internal/secrets")

Invoke-RestMethod "http://localhost:5100/api/secure/preview?url=$target"
I znowu dostaje 400 Bad Request:
{
  "error": "Host '127.0.0.1' nie znajduje się na allowliście."
}
Tym razem żądanie zostaje zatrzymane, zanim HttpClient w ogóle spróbuje nawiązać połączenie. Zwróć uwagę na zmianę podejścia: nie próbujemy tworzyć nieskończonej listy zabronionych adresów. Definiujemy konkretne miejsca, do których aplikacja ma prawo się łączyć - i to jest znacznie bezpieczniejsze.
Testy bezpieczeństwa: sprawdzaj próby obejścia
Zabezpieczenia powinny mieć testy, które obejmują próby ich ominięcia. Nie wystarczy sprawdzić, że poprawny adres przechodzi. W projekcie PublicApi.Tests (xUnit) testujemy wszystkie sztuczki z tego artykułu:
using Microsoft.Extensions.Options;

public sealed class SafeUrlValidatorTests
{
    private readonly SafeUrlValidator _validator;

    public SafeUrlValidatorTests()
    {
        var options = Options.Create(new UrlSafetyOptions
        {
            AllowedHosts =
            [
                "example.com",
                "www.example.com"
            ]
        });

        _validator = new SafeUrlValidator(options);
    }

    [Theory]
    [InlineData("http://example.com")]
    [InlineData("http://127.0.0.1:5101/internal/secrets")]
    [InlineData("https://localhost/admin")]
    [InlineData("https://127.0.0.1/admin")]
    [InlineData("https://[::1]/admin")]
    [InlineData("https://example.com.evil.test")]
    [InlineData("https://example.com@evil.test")]
    [InlineData("https://example.com:8443/data")]
    public void Validate_RejectsUnsafeUrls(string input)
    {
        var result = _validator.Validate(input);

        Assert.False(result.IsValid);
        Assert.NotNull(result.Error);
    }

    [Theory]
    [InlineData("https://example.com")]
    [InlineData("https://example.com/products/10")]
    [InlineData("https://www.example.com/api/data")]
    public void Validate_AcceptsAllowedUrls(string input)
    {
        var result = _validator.Validate(input);

        Assert.True(result.IsValid);
        Assert.NotNull(result.Uri);
        Assert.Null(result.Error);
    }
}
Pierwszy test sprawdza odrzucanie: HTTP zamiast HTTPS, localhost, IPv4, IPv6, fałszywą subdomenę, dane użytkownika i niestandardowy port. Drugi upewnia się, że walidator nie jest nadgorliwy i przepuszcza adresy z allowlisty. Całość uruchamiasz zwykłym dotnet test.
Najważniejsza zasada: kiedy znajdziesz nowy przypadek brzegowy, dopisz go do testów. Dzięki temu przyszła refaktoryzacja nie usunie zabezpieczenia po cichu.
Kod to tylko 1 warstwa ochrony
Allowlista w kodzie to bardzo dobre rozwiązanie, jeżeli znamy konkretne serwisy, z którymi aplikacja ma się komunikować. Nie powinniśmy jednak polegać wyłącznie na walidacji aplikacyjnej. Pełna ochrona to: walidacja aplikacyjna + ograniczenia sieciowe + monitoring + testy.
Ograniczenia sieciowe. W środowisku produkcyjnym warto ograniczyć ruch wychodzący na poziomie sieci. Aplikacja nie powinna mieć dostępu do każdego hosta i każdego portu tylko dlatego, że technicznie może taki ruch wykonać. Jeżeli błąd pojawi się w kodzie, ograniczenia sieciowe tworzą kolejną warstwę ochrony. Jest jeszcze jeden powód: allowlista sprawdza nazwę hosta, a nie adres IP, na który ta nazwa się rozwiązuje. Jeśli rekord DNS zaufanej domeny zacznie wskazywać na adres wewnętrzny, walidacja w kodzie tego nie zauważy - reguły sieciowe tak.
Monitoring. Warto też monitorować nietypowe połączenia wychodzące i błędy związane z próbami dostępu do lokalnych adresów. Seria odrzuconych adresów typu 127.0.0.1 w logach to wyraźny sygnał, że ktoś testuje Twoją aplikację.
Checklista: sprawdź każde miejsce, w którym serwer pobiera URL
Na koniec praktyczne zadanie. Wyszukaj w swoim projekcie użycia HttpClient, GetAsync, GetStringAsync i SendAsync (i pokrewnych metod). Zwróć szczególną uwagę na miejsca, w których część adresu albo cały URL pochodzi od użytkownika. I nie daj się uśpić: samo korzystanie z IHttpClientFactory nie zabezpiecza przed SSRF. Factory pomaga poprawnie zarządzać klientami HTTP, ale nadal to Ty decydujesz, dokąd aplikacja może wysyłać żądania.
Dla każdego znalezionego miejsca przejdź przez 11 pytań:
1. Czy użytkownik kontroluje pełny URL?
2. Czy pełny URL jest naprawdę potrzebny?
3. Czy można użyć stałego BaseAddress?
4. Czy host jest sprawdzany przez allowlistę?
5. Czy URL jest parsowany przez klasę Uri?
6. Czy przekierowania są wyłączone?
7. Czy ustawiono timeout?
8. Czy ograniczono rozmiar odpowiedzi?
9. Czy nie wysyłamy cookies i tokenów?
10. Czy mamy testy prób obejścia?
11. Czy ruch wychodzący jest ograniczony sieciowo?
Jeśli miałbyś zapamiętać z tego artykułu tylko 1 zdanie, niech to będzie to: nie pozwalaj użytkownikowi wybierać celu żądania, jeżeli nie jest to absolutnie konieczne.
Ściąga: pozorne zabezpieczenia i co zamiast nich
| Pozorna poprawka | Jak ją obejść | Co zamiast |
| Blokowanie słowa "localhost" | 127.0.0.1, [::1] albo inny zapis prowadzący do tego samego miejsca | Allowlista dozwolonych hostów zamiast listy zakazanych |
| StartsWith("https://example.com") | example.com.evil.test, example.com@evil.test | Parsowanie przez Uri, porównanie całego hosta, odrzucenie UserInfo |
| Tylko HTTPS | Usługa wewnętrzna też może działać na HTTPS | HTTPS jako 1 z warstw, nie jedyna ochrona |
| Sprawdzenie tylko pierwszego adresu | 302 Redirect z zaufanego hosta na adres wewnętrzny | AllowAutoRedirect = false albo walidacja każdego kolejnego adresu |
| "Używamy IHttpClientFactory, więc jest bezpiecznie" | Factory zarządza klientami, nie decyduje, dokąd idą żądania | Stały BaseAddress albo allowlista + bezpieczna konfiguracja klienta |
Podsumowanie
Do stworzenia poważnej podatności nie potrzeba skomplikowanego kodu. Czasami wystarczą 3 poprawne technicznie linijki i 1 błędne założenie dotyczące danych od użytkownika. Najważniejsze wnioski:
• SSRF to sytuacja, w której użytkownik wybiera cel, a serwer wykonuje żądanie - z własnej sieci i własnego środowiska.
• Blokowanie localhost, StartsWith i samo HTTPS tylko wyglądają jak zabezpieczenie, a przekierowania potrafią ominąć nawet poprawną walidację pierwszego adresu.
• Najbezpieczniej w ogóle nie pozwalać użytkownikowi wybierać hosta: stały BaseAddress w typowanym kliencie, a od użytkownika tylko identyfikator.
• Gdy pełny URL jest konieczny: parsowanie przez Uri, allowlista hostów, tylko HTTPS, bez danych użytkownika i niestandardowych portów.
• HttpClient bez automatycznych przekierowań i cookies, z krótkim timeoutem i limitem rozmiaru odpowiedzi.
• Testy prób obejścia, ograniczenia sieciowe i monitoring jako kolejne warstwy ochrony.
Jeśli chcesz nauczyć się świadomie zabezpieczać aplikacje w C# i ASP.NET Core, zajrzyj do mojej Szkoły Bezpieczeństwa C#/.NET. Przechodzimy w niej praktycznie przez najważniejsze zagrożenia występujące w aplikacjach .NET: SQL Injection, XSS, CSRF, SSRF, błędy uwierzytelniania, JWT, cookies, Brute Force, Rate Limiting, kryptografię, bezpieczne logowanie i obsługę wyjątków. Nie zatrzymujemy się na samych definicjach - pracujemy na kodzie, pokazujemy podatne rozwiązania, przeprowadzamy ataki w środowisku testowym, a następnie krok po kroku poprawiamy aplikację.
Szczegóły znajdziesz tutaj: modestprogrammer.pl/szkola-bezpieczenstwa-csharp-dotnet. Jeśli zapisy są akurat zamknięte, możesz dołączyć do listy oczekujących - wtedy nie ominą Cię żadne informacje o szkoleniu.
Pamiętaj: bezpieczeństwo aplikacji nie zaczyna się podczas audytu. Zaczyna się w momencie, w którym piszesz pierwszą linię kodu.