Wydajność aplikacji ma dziś kluczowe znaczenie dla doświadczenia użytkownika - a jednym z najskuteczniejszych sposobów na jej poprawę jest cache, czyli pamięć podręczna. Idea jest prosta: często wykorzystywane dane trzymamy tymczasowo w szybkim magazynie, dzięki czemu kolejne żądania o te same informacje obsługujemy błyskawicznie, bez ponownego sięgania do wolniejszego źródła (najczęściej bazy danych). Efekt? Krótszy czas odpowiedzi i realnie odciążona baza.
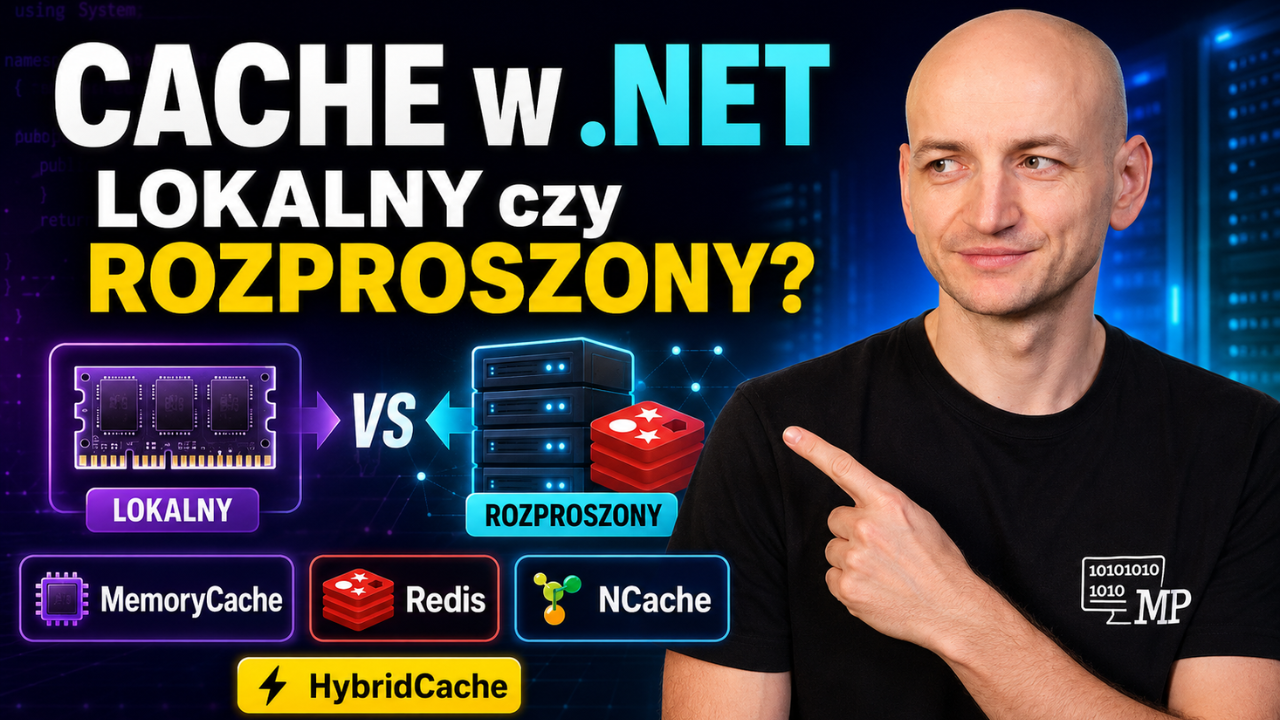
W ekosystemie .NET mamy do wyboru kilka podejść. 2 klasyczne to cache lokalny w pamięci procesu (klasa MemoryCache / interfejs IMemoryCache) oraz cache rozproszony, dostępny przez sieć - tu prym wiedzie otwartoźródłowy Redis, a w środowiskach .NET popularny jest też komercyjny NCache. Do tego doszło ostatnio 3, hybrydowe podejście: HybridCache, które łączy zalety obu światów i o którym opowiem w dalszej części.
W tym artykule porównamy te rozwiązania i pokażemy, kiedy sięgnąć po które. Omówimy typowe scenariusze (buforowanie kosztownych zapytań, dane sesyjne, cache rzadko zmieniających się danych statycznych) oraz 3 kwestie, które w praktyce decydują o powodzeniu strategii cachingowej: trwałość danych, skalowanie i spójność względem źródła.
Wersje .NET: wszystkie opisane techniki działają w .NET 8, 9 i 10. MemoryCache i cache rozproszony są dostępne od dawna, natomiast HybridCache to biblioteka wprowadzona w .NET 9 (i wspierana również w .NET 10). Warto o tym pamiętać, bo część projektów wciąż siedzi na starszych podejściach, choć ma pod ręką coś wygodniejszego.
Cache w pamięci lokalnej (MemoryCache)
MemoryCache przechowuje dane w pamięci RAM procesu aplikacji. W praktyce oznacza to, że cache'owane dane widzi wyłącznie ta konkretna instancja aplikacji - nie są one współdzielone między różnymi serwerami czy procesami.
Rozwiązanie jest banalnie proste w użyciu. W ASP.NET Core wystarczy zarejestrować usługę:
builder.Services.AddMemoryCache();a następnie wstrzyknąć IMemoryCache tam, gdzie chcemy z niego korzystać:
if (!_memoryCache.TryGetValue(id, out Produkt produkt))
{
    produkt = PobierzZBazyDanych(id);
    _memoryCache.Set(id, produkt, TimeSpan.FromMinutes(5));
}
Najpierw sprawdzamy, czy w cache jest obiekt Produkt o danym id. Jeśli nie (cache miss), pobieramy go z bazy i zapisujemy na 5 minut. Kolejne odwołania z tym samym kluczem będą już natychmiastowe.
Ten kod ma jednak subtelną wadę, o której warto wiedzieć: pod dużym obciążeniem, gdy wpis wygaśnie, wiele żądań naraz trafi na cache miss i wszystkie równolegle uderzą w bazę, żeby odbudować ten sam wpis. To tzw. cache stampede (nawałnica na bazę). Prostszą, bezpieczniejszą wersją jest GetOrCreateAsync, które łączy sprawdzenie i zapis w jedną operację:
var produkt = await _memoryCache.GetOrCreateAsync(id, entry =>
{
    entry.AbsoluteExpirationRelativeToNow = TimeSpan.FromMinutes(5);
    return PobierzZBazyDanychAsync(id);
});Zalety. Operacje są ekstremalnie szybkie - odczyt z RAM-u to rząd nanosekund, czyli szybciej niż jakiekolwiek zapytanie do bazy czy sieciowy dostęp do zewnętrznego magazynu. MemoryCache nie wymaga też żadnej dodatkowej infrastruktury: nie stawiamy osobnego serwera cache. To sprawia, że świetnie sprawdza się w prostych scenariuszach i w aplikacjach działających na pojedynczym serwerze (bez skalowania poziomego).
Wady i ograniczenia. Skoro cache żyje w pamięci procesu, jego zawartość znika przy każdym restarcie aplikacji - nowy deployment czy awaria zaczynają od pustego cache. Co ważniejsze, w środowisku z wieloma serwerami każdy z nich buforuje dane osobno. Przy farmie 5 serwerów mamy 5 niezależnych cache'y, co prowadzi do 2 problemów: niespójności (jeden serwer ma już świeże dane, inny wciąż stare) oraz marnowania pamięci (te same dane są zcache'owane 5 razy). Dlatego przy aplikacjach działających na więcej niż jednej maszynie zwykle rozważa się cache rozproszony - zamiast lokalnego MemoryCache albo obok niego.
Cache rozproszony (Redis, NCache)
Cache rozproszony trzyma dane w zewnętrznym magazynie, do którego mają dostęp wszystkie instancje aplikacji. Zamiast pamięci procesu wykorzystujemy osobny serwer lub klaster, z którym aplikacje komunikują się przez sieć.
Najpopularniejszym rozwiązaniem jest Redis - wysokowydajny magazyn klucz-wartość działający w pamięci. W świecie .NET często używany jest też NCache, natywne dla platformy rozwiązanie firmy Alachisoft, dostępne komercyjnie (ma również edycję open-source).
Jak to działa? Uruchamiamy serwer cache (instancję Redis na osobnej maszynie lub w chmurze, albo klaster NCache), a aplikacja łączy się z nim przez klienta. .NET udostępnia tu ustandaryzowany interfejs IDistributedCache, dla którego istnieją gotowe implementacje:
/* Redis jako IDistributedCache */
builder.Services.AddStackExchangeRedisCache(options =>
{
    options.Configuration = builder.Configuration.GetConnectionString("Redis");
});
Powyższy pakiet Microsoft.Extensions.Caching.StackExchangeRedis korzysta pod spodem z biblioteki StackExchange.Redis. Analogicznie NCache dostarcza własnego providera (AddNCacheDistributedCache). Kiedy aplikacja zapisuje lub odczytuje dane, wysyła zapytanie do serwera cache po sieci - a jeśli działa w wielu instancjach (chmura, mikroserwisy, farma serwerów), wszystkie odwołują się do tej samej, wspólnej pamięci podręcznej.
Zalety. Przede wszystkim znika problem spójności i duplikacji z przykładu z MemoryCache. Zamiast 5 niezależnych cache'y mamy 1 wspólny - jeśli 1 serwer coś zapisze, pozostałe od razu to widzą. Dzięki temu bazę odciążamy skuteczniej niż przy lokalnych cache'ach per serwer. Taki cache może też być trwały: Redis opcjonalnie zapisuje dane na dysk (snapshoty RDB lub log AOF), a NCache oferuje własny mechanizm trwałości i replikacji dla wysokiej dostępności. Wreszcie oba rozwiązania skalują się poziomo - Redis w trybie klastrowym rozkłada dane na wiele węzłów i replikuje je, zapewniając więcej pamięci i odporność na awarię pojedynczego węzła. NCache dokłada do tego bogate topologie (partycjonowanie, replikacja, mirroring) oraz funkcje przydatne w dużych wdrożeniach enterprise: tagowanie i grupowanie elementów, zapytania SQL/LINQ po obiektach w cache czy mechanizmy read-through/write-through.
Wyzwania i koszty. Cache rozproszony zwiększa złożoność architektury - dochodzi kolejny komponent do utrzymania (serwer/klaster Redis lub NCache), a z nim narzut administracyjny i potencjalne koszty (opłata za Azure Cache for Redis, licencja na komercyjny NCache). Dostęp przez sieć jest też wolniejszy niż lokalny: typowy odczyt z Redis to pojedyncze milisekundy - bardzo szybko, ale wciąż odczuwalnie więcej niż kilkanaście nanosekund dostępu do RAM-u procesu. Innymi słowy, Redis jest znakomity, ale MemoryCache na tej samej maszynie zawsze będzie szybszy. W praktyce te pojedyncze milisekundy to akceptowalna cena za skalowalność i spójność - i wciąż wielokrotnie mniej niż odczyt z bazy czy dysku. Nic dziwnego, że mnóstwo aplikacji produkcyjnych używa Redis jako głównego magazynu cache. NCache również oferuje niskie opóźnienia, a że jest projektowany pod .NET, integruje się z platformą bezpośrednio, bez pośrednictwa zewnętrznych bibliotek.
Podejście hybrydowe: HybridCache (.NET 9+)
Do niedawna, jeśli chcieliśmy mieć jednocześnie szybkość cache'u lokalnego i spójność cache'u rozproszonego, musieliśmy budować dwupoziomowy cache (L1 + L2) ręcznie: lokalny MemoryCache jako L1 i Redis jako L2, z całą obsługą serializacji, generowania kluczy i synchronizacji napisaną samodzielnie. Działało, ale było pracochłonne i łatwe do popsucia.
W .NET 9 pojawiła się biblioteka HybridCache (pakiet Microsoft.Extensions.Caching.Hybrid), która robi to za nas i jest już produkcyjnie gotowa (GA). Zbudowana jest na IDistributedCache, więc współpracuje ze wszystkimi istniejącymi backendami - Redis, SQL Server, CosmosDB, Garnet itd. Rejestracja to dosłownie jedna linia (a jeśli dodamy też backend rozproszony, HybridCache automatycznie użyje go jako warstwy L2):
builder.Services.AddStackExchangeRedisCache(options =>
{
    options.Configuration = builder.Configuration.GetConnectionString("Redis");
});

builder.Services.AddHybridCache(); /* L1 (pamięć) + L2 (Redis) automatycznie */
Użycie sprowadza się do jednego wywołania GetOrCreateAsync, które zastępuje cały wzorzec "sprawdź cache → jak nie ma, pobierz ze źródła → zapisz":
var produkt = await _hybridCache.GetOrCreateAsync(
    $"produkt-{id}",                                   /* klucz */
    async token => await PobierzZBazyDanychAsync(id),  /* fabryka danych przy cache miss */
    cancellationToken: ct);
Co HybridCache daje w zamian:
• 2 poziomy cache bez pisania kodu. L1 w pamięci procesu (szybkość) + L2 rozproszony (spójność między serwerami). Deserializację płacimy raz - obiekt ląduje w L1 i kolejne odczyty na tym samym serwerze są już natychmiastowe. Czas życia obu warstw ustawiamy osobno przez HybridCacheEntryOptions (LocalCacheExpiration dla L1, Expiration dla L2). Zwykle warto trzymać L1 krótszy niż L2, żeby ograniczyć okno nieaktualności.
• Ochrona przed cache stampede. Gdy wiele żądań naraz trafi na ten sam brakujący klucz, fabryka danych wykona się tylko raz, a pozostałe żądania poczekają na wynik. To rozwiązuje problem, który zwykły IMemoryCache po prostu ignoruje.
• Unieważnianie po tagach. Wpisom można nadawać tagi i kasować je hurtowo jednym wywołaniem RemoveByTagAsync("kategoria-5"), zamiast usuwać klucze pojedynczo.
Jest jednak jeden istotny niuans dotyczący spójności, o którym trzeba wiedzieć: unieważnienie wpisu (po kluczu lub tagu) usuwa go z bieżącego serwera i z magazynu rozproszonego (L2), ale kopie w pamięci L1 na innych serwerach pozostają, dopóki nie wygasną naturalnie. Dlatego przy danych, które muszą być świeże "niemal w czasie rzeczywistym" na wszystkich węzłach, i tak warto trzymać krótkie LocalCacheExpiration. HybridCache nie jest też najlepszym wyborem do danych sesyjnych ani per-użytkownik - tam L1 rzadko coś daje i zwykle lepiej sprawdza się sam IDistributedCache na Redisie.
Które podejście wybrać? Skrótowe porównanie
| Cecha | MemoryCache (L1) | Redis / NCache (rozproszony) | HybridCache (L1 + L2) |
| Zasięg danych | jeden proces | wspólny dla wszystkich instancji | L1 lokalny + L2 wspólny |
| Szybkość odczytu | najwyższa (RAM) | pojedyncze ms (sieć) | RAM przy trafieniu w L1 |
| Spójność między serwerami | brak | wysoka | wysoka (L2) + niuans L1 |
| Trwałość po restarcie | brak | tak (opcjonalnie) | tak (przez L2) |
| Skalowanie poziome | słabe | bardzo dobre | bardzo dobre |
| Ochrona przed stampede | brak (chyba że ręcznie) | brak (chyba że ręcznie) | wbudowana |
| Dodatkowa infrastruktura | żadna | serwer/klaster cache | serwer/klaster cache (dla L2) |
| Najlepsze do | pojedynczy serwer, prostota | klaster, sesje, wysoka dostępność | odczytowo-ciężkie dane współdzielone |
Scenariusze użycia
Buforowanie wyników zapytań do bazy. Najbardziej klasyczne zastosowanie. Kiedy aplikacja wykonuje kosztowne zapytanie, warto zapamiętać rezultat, żeby kolejne żądania dostały gotową odpowiedź niemal natychmiast - świetnie nadają się do tego wyniki wyszukiwania, listy produktów czy rankingi. Na pojedynczej instancji wystarczy MemoryCache. Przy wielu serwerach lepszy będzie cache rozproszony lub HybridCache, żeby wszystkie instancje korzystały z tej samej odpowiedzi. Kluczowe jest ustalenie sensownej polityki wygaszania (TTL) dopasowanej do dynamiki zmian danych, żeby nie serwować przeterminowanych informacji.
Przechowywanie sesji użytkowników. Aplikacje webowe często trzymają dane sesyjne po stronie serwera. Domyślna sesja In-Memory w ASP.NET Core działa prosto na jednym serwerze, ale przy skalowaniu przestaje wystarczać - użytkownik trafiający na inny węzeł traci stan (chyba że wymusimy sticky sessions na load balancerze, co bywa zawodne). Lepszym rozwiązaniem jest rozproszony magazyn sesji: Redis dzięki swojej szybkości idealnie nadaje się do obsługi tysięcy aktywnych sesji, a ASP.NET Core pozwala go łatwo podpiąć jako dostawcę Session State. Dane są wtedy dostępne dla wszystkich instancji i mogą przetrwać restart aplikacji. To scenariusz, w którym sięgamy raczej po sam IDistributedCache na Redisie niż po HybridCache.
Cache danych statycznych i referencyjnych. Wiele aplikacji korzysta ze zbiorów, które zmieniają się rzadko, a czytane są bardzo często: słowniki (lista krajów, kody pocztowe), konfiguracje systemowe czy wynik kosztownej operacji ważny przez dłuższy czas. Takie dane warto załadować do cache raz i nie odpytywać za każdym razem bazy. Na pojedynczym wdrożeniu wystarczy MemoryCache. Gdy jednak instancji jest wiele i zależy nam na spójności, lepiej sprawdzi się cache rozproszony lub HybridCache - po zmianie np. przez administratora wszystkie serwery zobaczą nową wartość od razu (lub, przy HybridCache, po krótkim wygaśnięciu warstwy L1), zamiast żmudnej synchronizacji każdego węzła z osobna. To także modelowy przypadek dla HybridCache: dane odczytywane często, współdzielone i rzadko zmieniane.
Trwałość, skalowanie i spójność
Trwałość danych. Chodzi o to, czy dane w cache przetrwają restart usługi lub awarię. Dla MemoryCache odpowiedź brzmi: nie - cała zawartość znika wraz z procesem, więc po wdrożeniu nowej wersji cache startuje od zera. Cache rozproszony żyje niezależnie od pojedynczej aplikacji, więc restart jednego serwera go nie opróżnia. Trzeba jednak pamiętać, że sam serwer cache też może paść - domyślnie Redis trzyma dane w RAM i utrata zasilania oznacza utratę cache'u (dlatego istnieją snapshoty RDB, log AOF i replikacja między węzłami). Ważne, że cache z założenia nie jest źródłem prawdy - nawet jego całkowitą utratę da się przeżyć: system po prostu przez chwilę częściej odpyta bazę, aż cache się ponownie zapełni. Jeśli jednak scenariusz absolutnie wymaga zachowania danych między restartami (np. sesje w klastrze bez sticky session), przewagę ma cache rozproszony z włączoną trwałością.
Skalowalność. Tu podejścia różnią się fundamentalnie. MemoryCache skaluje się pionowo - dokładamy RAM do maszyny, żeby zmieścić więcej danych. Nie pomaga natomiast przy skalowaniu poziomym: każdy nowy serwer ma osobny cache, który trzeba osobno napełnić i który zajmuje dodatkową pamięć. Cache rozproszony (i HybridCache w warstwie L2) projektowany jest właśnie pod skalowanie poziome - wiele instancji współdzieli jeden cache, więc dodanie serwera nie powiela pamięci na cache, a nowy węzeł od razu korzysta z istniejących danych. Sam klaster cache też możemy skalować, dokładając węzły lub zasoby. Duże wdrożenia potwierdzają, że Redis przy odpowiedniej architekturze obsługuje setki tysięcy operacji na sekundę.
Spójność danych. Cache zawsze wprowadza ryzyko, że serwowane dane nie będą w 100% aktualne - to cena za wydajność. Warto rozróżnić 2 poziomy. Po pierwsze, spójność między instancjami aplikacji: tu cache rozproszony wygrywa, bo wszystkie węzły czytają i piszą do tej samej puli - zmiana u jednego jest natychmiast widoczna u pozostałych. Przy cache lokalnym osiągnięcie tego jest trudne (wymagałoby rozsyłania informacji o zmianach do wszystkich serwerów), więc zwykle godzimy się, że węzły przez chwilę operują na nieco rozjechanych danych, dopóki wpisy się nie odświeżą. HybridCache stoi tu pośrodku: L2 jest spójny, ale kopie w L1 na innych serwerach dożywają swojego TTL. Po drugie, spójność ze źródłem danych: ten problem dotyczy każdego rodzaju cache. Jeśli dane w bazie się zmienią, cache może przez jakiś czas trzymać starą wartość (stale data). Radzimy sobie z tym przez rozsądny TTL (krótszy dla danych zmiennych) oraz aktywne unieważnianie/aktualizację wpisów przy zmianie w bazie (co bywa skomplikowane, ale np. tagi w HybridCache mocno to upraszczają).
Słynne powiedzenie głosi, że w informatyce są tylko 2 naprawdę trudne rzeczy: unieważnianie cache i nazywanie zmiennych. Coś w tym jest :) Wybierając strategię keszowania, zawsze musimy świadomie zdecydować, jak zapewnimy akceptowalną świeżość danych - cache rozproszony ułatwia spójność między instancjami, ale nie zwalnia nas z myślenia o spójności ze źródłem.
Podsumowanie
Dobrze użyty cache potrafi drastycznie przyspieszyć aplikację .NET i odciążyć bazę danych. MemoryCache jest idealny w prostych przypadkach i na pojedynczym serwerze - banalny w implementacji i najszybszy z możliwych. Cache rozproszony (Redis, NCache) staje się nieoceniony, gdy aplikacja działa w klastrze albo wymaga wysokiej dostępności i spójności między wieloma instancjami; skaluje się poziomo i oferuje trwałość, kosztem większej złożoności.
A jeśli zależy nam jednocześnie na szybkości cache'u lokalnego i spójności cache'u rozproszonego, nie musimy już budować dwupoziomowego cache'u ręcznie - od .NET 9 mamy do tego HybridCache, który dokłada L1+L2, ochronę przed cache stampede i unieważnianie po tagach w jednym, prostym API. Dla nowych, odczytowo-ciężkich aplikacji korzystających z Redisa to często najrozsądniejszy punkt startowy.
Ostateczny wybór zależy od projektu: warto rozważyć, jak bardzo aplikacja potrzebuje skalowalności i spójności, a jak bardzo liczy się minimalne opóźnienie i prostota wdrożenia. Najlepsze rezultaty zwykle daje świadome łączenie podejść i dostrajanie czasów życia danych do konkretnych potrzeb.
Jeśli tego typu praktyczne rozkminy o wydajności i architekturze aplikacji .NET są dla Ciebie wartościowe, to mam coś dla Ciebie. Raz na jakiś czas wysyłam maila do zamkniętej grupy programistów - bez lania wody, za to z konkretnymi wskazówkami, kulisami moich projektów i materiałami, których nie publikuję nigdzie indziej. To trochę jak rozmowa o kodzie przy kawie z kimś, kto siedzi w temacie na co dzień.
Jeśli chcesz dołączyć, zostaw swój adres tutaj: modestprogrammer.pl/vip. Do zobaczenia po drugiej stronie - i powodzenia w optymalizacji aplikacji.