Ile Twoja firma wydaje rocznie na architekturę? Nie na serwery i nie na licencje, tylko na samą architekturę. Większość zespołów nigdy tego nie liczy. A jeśli macie mikroserwisy, a nie jesteście Netflixem, jest duża szansa, że przepalacie kilkaset tysięcy złotych rocznie na rozwiązywanie problemów, które... sami sobie stworzyliście.
Mikroserwisy przez lata urosły do rangi "dojrzałej architektury", a słowo "monolit" zaczęło brzmieć jak wstyd. Tymczasem dla większości firm to najdroższa decyzja architektoniczna, jaką można podjąć. Nie dlatego, że mikroserwisy są złe, tylko dlatego, że są drogie - a rachunek przychodzi w miejscach, których nikt nie pokazuje na konferencyjnych slajdach.
W tym artykule dostaniesz 3 rzeczy, bez ewangelizacji: pełny rachunek za mikroserwisy (5 kosztów i przykładowe kwoty w złotówkach), twarde dowody od firm, które przeszły to na własnej skórze (m.in. Prime Video, gdzie uproszczenie architektury obniżyło koszty infrastruktury o ponad 90%), oraz konkretny plan, co robić zamiast: modularny monolit w .NET, ze strukturą solucji, kodem i ścieżką migracji. Na koniec znajdziesz checklistę 5 pytań, którą warto przejść, zanim ktokolwiek u Was podpisze zgodę na mikroserwisy.
Stan danych: październik 2026. Kwoty w rachunku to przykładowe, ostrożne szacunki dla firmy w Polsce: 8 programistów i ok. 10 serwisów. Nie obejmują kosztów opóźnień w roadmapie, rotacji ludzi ani wolniejszego onboardingu. Warto podstawić własne stawki i policzyć to dla swojego zespołu.
Skąd moda na mikroserwisy?
Zanim policzymy pieniądze, warto zrozumieć, skąd w ogóle bierze się presja na mikroserwisy. Najczęściej stoją za nią 3 rzeczy.
"Netflix tak robi". Znasz to. Ktoś wraca z konferencji i mówi: Netflix tak robi, Amazon tak robi, Uber tak robi. Więc my też musimy. Brzmi logicznie. I jest kompletnie nielogiczne, bo wystarczy popatrzeć na skalę:
• Netflix. Ogromna organizacja techniczna, setki zespołów produktowych, ponad 300 mln płatnych użytkowników i własna platforma narzędzi.
• Twoja firma. 8 programistów, 1-2 zespoły, 5000 użytkowników i DevOps robiony "po godzinach".
Kopiując architekturę Netflixa, kopiujesz lekarstwo na chorobę, której nie masz. Rozwiązania wielkich firm powstały pod ich problemy - setki zespołów, które muszą pracować i wdrażać niezależnie od siebie. Twoja firma tych problemów zwyczajnie nie ma.
CV-driven development. Druga przyczyna ma nawet swoją nazwę: CV-driven development, czyli dobór architektury pod przyszłe CV, a nie pod obecny biznes. Objawy łatwo rozpoznać:
• Kubernetes w firmie z 200 użytkownikami,
• Kafka do 10 zdarzeń na minutę,
• 12 mikroserwisów na 4 programistów.
Jeśli tak wygląda Twoja architektura, problem nie leży w technologii. Leży w decyzji.
"Monolit" stał się obelgą. I trzecia rzecz: słowo "monolit" zaczęło brzmieć jak obelga. Niesłusznie. Monolit to nie brak architektury. Bałagan to brak architektury. A bałagan da się zrobić także w 40 serwisach - tyle że wtedy jest jeszcze rozproszony.
Dość psychologii, policzmy pieniądze. Poniżej 5 kosztów mikroserwisów, które rzadko trafiają na konferencyjne slajdy.
Koszt #1: sieć
W monolicie wywołanie metody, np. orders.Place(), trwa rzędu 10 nanosekund. W mikroserwisach ta sama operacja idzie po sieci jako POST /api/orders - i nagle mówimy o rzędzie 10 milisekund. W prostym porównaniu to różnica nawet do 1 000 000 razy. Każda granica serwisu zamienia zwykłe wywołanie metody w połączenie sieciowe: z opóźnieniem, serializacją i awariami w pakiecie.
A sieć czasem po prostu nie działa. I to nie jest tylko kwestia szybkości. "Sieć jest niezawodna" to mit numer 1 systemów rozproszonych - pierwsze z tzw. błędnych założeń przetwarzania rozproszonego (fallacies of distributed computing). Skoro sieć potrafi zawieść, do każdego wywołania między serwisami dopisujesz nowy, obowiązkowy kod:
• retry, bo żądanie może się nie udać za pierwszym razem,
• timeout, bo drugi serwis może nie odpowiedzieć wcale,
• circuit breaker, żeby awaria jednego serwisu nie pociągnęła za sobą kolejnych,
• idempotencję, bo po retry ta sama operacja może dotrzeć 2 razy.
W monolicie ten kod nie istnieje. Bo nie musi.
Koszt #2: transakcje i sagi
Moim zdaniem to koszt najbardziej bolesny. W monolicie masz BEGIN TRANSACTION i COMMIT, a cała operacja biznesowa wykonuje się według zasady "wszystko albo nic". Między serwisami to już tak prosto nie działa. Jedna operacja biznesowa rozjeżdża się na kilka baz danych i tracisz prostą gwarancję "wszystko albo nic". W zamian dostajesz sagi, kompensacje i eventual consistency.
"Złóż zamówienie" - przed i po. Zobacz na przykładzie. W monolicie złożenie zamówienia to 3 kroki: zamówienie, płatność, magazyn. Jedna transakcja, wszystko albo nic. W mikroserwisach ta sama operacja to saga rozproszona przez 4 serwisy: Orders, Payments, Inventory i Notifications. Każda strzałka między nimi to sieć, retry, timeout i serializacja. Do tego dochodzą kompensacje (cofanie kroków, które już się wykonały, gdy kolejny się wywali), dead-letter na komunikaty, których nie udało się przetworzyć, i monitoring samej sagi. Ten sam feature, a wielokrotnie więcej miejsc, w których coś może się wywalić.
Eventual consistency, czyli "zaraz się zgodzi". Najgorsze jest to, że skutki widzi biznes, nie tylko programiści:
• klient zapłacił, a zamówienie "nie istnieje",
• raport sprzedaży nie zgadza się ze stanem magazynu,
• support ma nową procedurę: "proszę odświeżyć za minutę".
To nie jest bug. To eventual consistency - architektura, którą sam wybrałeś.
Koszt #3: infrastruktura
Oto typowa lista zakupów, żeby mikroserwisy dało się sensownie utrzymać:
• API Gateway - wejście do systemu,
• Kubernetes - orkiestracja kontenerów,
• service mesh - ruch między serwisami,
• message broker - Kafka albo RabbitMQ,
• distributed tracing - OpenTelemetry, Jaeger,
• centralne logi - ELK albo Seq,
• monitoring i alerty - Prometheus, Grafana,
• service discovery i centralna konfiguracja,
• CI/CD - razy liczba serwisów.
Każda pozycja to czyjś czas. Czyli Twoje pieniądze.
To nie są narzędzia, to etaty. Umówmy się: ta lista to nie zestaw narzędzi, które instalujesz raz i zapominasz. Ktoś musi to wszystko postawić, aktualizować i łatać. I ktoś musi do tego wstawać o 3:00 w nocy.
Koszt #4: debugowanie
Porównaj, jak wygląda szukanie błędu w obu światach.
W monolicie. Leci exception, masz pełny stack trace, stawiasz breakpoint, wciskasz F5 i naprawiasz. Czasem to kwestia 15 minut.
W mikroserwisach. Szukasz correlation ID, przeglądasz logi z 6 serwisów, wchodzisz w distributed tracing i zgadujesz, czyje wdrożenie to zepsuło. Czasem to 2 dni.
I ta różnica nie zdarza się raz. Wraca przy każdej kolejnej awarii. A awarii w systemie rozproszonym masz więcej, bo każde połączenie sieciowe to kolejne miejsce, w którym coś może pójść nie tak.
Koszt #5: ludzie
Mikroserwisy zakładają zespół, którego większość firm po prostu nie ma:
• Platform team. Ktoś, kto na pełny etat utrzymuje platformę pod serwisami.
• Dyżury on-call 24/7. Awaria o 3:00 w nocy nie poczeka do porannego stand-upu.
• Seniorzy od systemów rozproszonych. Junior nie zdebuguje sagi rozsypanej po 6 serwisach.
• Dojrzały DevOps. Pełna automatyzacja: build, deploy, rollback - bez wyjątków.
Rekrutacja tych ludzi to osobny - i drogi - projekt.
Ile kosztują mikroserwisy? Przykładowy rachunek roczny
Zbierzmy to wszystko w jeden rachunek. Weźmy typową firmę: 8 programistów, ok. 10 serwisów, Polska, 2026 rok.
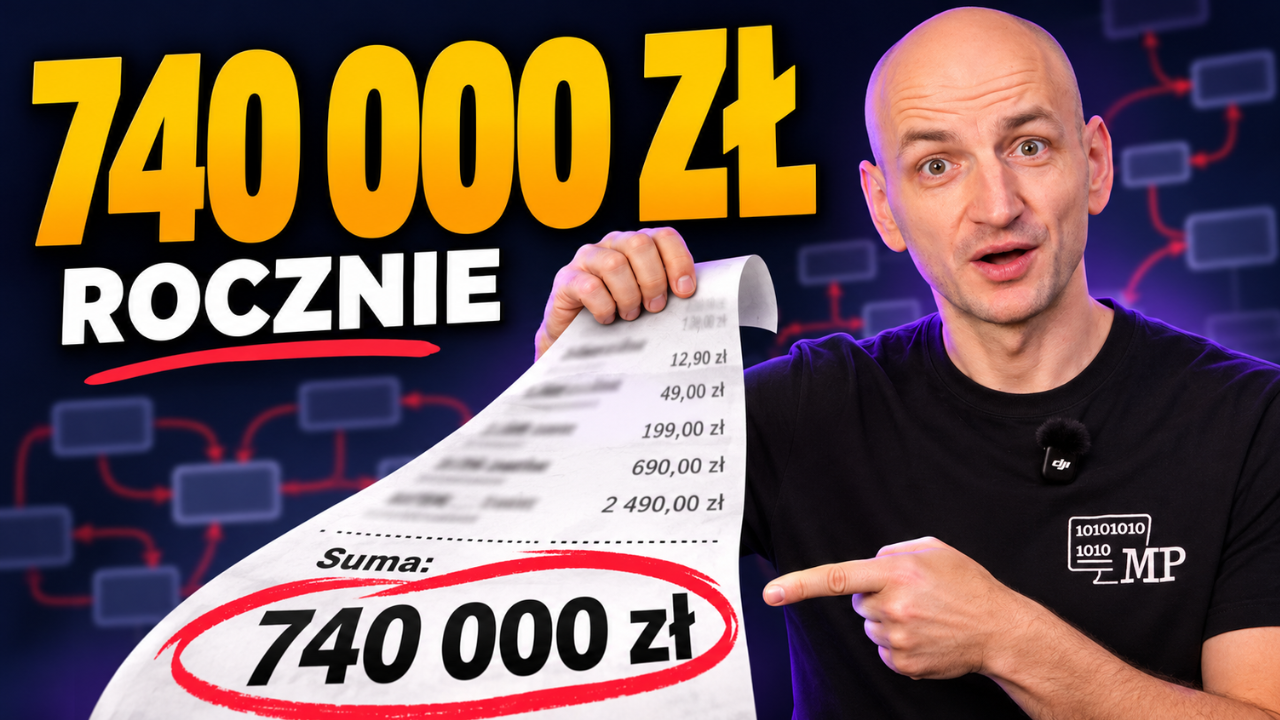
• Dodatkowa infrastruktura (klaster, broker, observability): ok. 60 000 zł rocznie.
• Platform / DevOps engineer, czyli etat, którego wcześniej nie było: ok. 300 000 zł rocznie.
• "Podatek rozproszony". Wszystkie retry, sagi i debugowanie po kilku serwisach zjadają, licząc konserwatywnie, ok. 20% czasu 8-osobowego zespołu. W przeliczeniu to ok. 1,6 etatu, czyli kolejne ok. 380 000 zł rocznie.
Razem: ok. 740 000 zł rocznie. I to są ostrożne szacunki - bez kosztów opóźnień w roadmapie, rotacji ludzi i wolniejszego onboardingu.
Prawie 3/4 miliona złotych. Rocznie. Wydane na obsługę problemów, których w monolicie w ogóle nie było. Właśnie dlatego mikroserwisy na wyrost nazywam najdroższym błędem, jaki może popełnić firma.
Dowody, nie opinie: Prime Video, Stack Overflow, Shopify i Segment
Może myślisz: łatwo tak gadać. Dlatego teraz nie opinie, tylko przykłady firm, które policzyły to samo i wyciągnęły wnioski.
Amazon Prime Video: -90% kosztów infrastruktury. W 2023 roku zespół Prime Video odpowiedzialny za monitoring jakości audio-wideo opisał, jak przeszedł z rozproszonej architektury serverless (opartej m.in. na AWS Step Functions i Lambda) na jeden proces uruchamiany w ECS. Mniej orkiestracji, mniej kosztów - a dokładniej koszty infrastruktury niższe o ponad 90%. Zwróć uwagę, kto to zrobił: Amazon. Firma, która sprzedaje chmurę, w której często takie rozproszone systemy się hostuje.
Nie tylko oni. Podobnych historii jest więcej:
• Stack Overflow. W znanym opisie architektury z 2016 roku (autorstwa Nicka Cravera): jedna aplikacja Q&A na ASP.NET i 9 głównych serwerów webowych. Jeden z najpopularniejszych serwisów dla programistów, a w jego centrum jedna aplikacja.
• Shopify. Ogromny system (w Ruby on Rails) rozwijany latami jako modularny monolit. Skala e-commerce, a mimo to twarde granice wewnątrz jednej aplikacji zamiast rozproszenia.
• Segment. Mieli ponad 100 mikroserwisów i wrócili do monolitu. Ich wpis z 2018 roku nazywa się dosłownie "Goodbye Microservices".
Martin Fowler: najpierw monolit. A Martin Fowler, człowiek, który spopularyzował samo pojęcie mikroserwisów, w tekście "MonolithFirst" z 2015 roku pisze wprost:
"Niemal wszystkie historie sukcesu mikroserwisów zaczynały się od monolitu, który zrobił się za duży."
Od monolitu. Nie od diagramu z 20 kwadracikami na dzień dobry.
Kiedy mikroserwisy mają sens?
Żeby było jasne: nie twierdzę, że mikroserwisy są złe. Twierdzę, że są drogie. A czasem warto za nie zapłacić. Kiedy? Gdy spełniasz wszystkie 4 warunki:
1. Masz kilkudziesięciu (lub więcej) programistów w wielu zespołach.
2. Te zespoły realnie blokują się nawzajem przy wdrożeniach.
3. Część systemu ma skrajnie inne wymagania skalowania - i masz na to metryki, a nie przeczucia.
4. Organizacja naprawdę umie w on-call, observability i pełną automatyzację.
4 na 4? OK - wtedy mikroserwisy mogą się bronić.
Problem organizacyjny, nie techniczny. Zauważ wspólny mianownik tej listy: to wszystko są problemy z ludźmi, a nie z kodem. Mikroserwisy rozwiązują problem organizacyjny, nie techniczny. To narzędzie do skalowania zespołów, czyli prawo Conwaya w praktyce. Prawo Conwaya mówi, że struktura systemu odzwierciedla strukturę komunikacji w organizacji, która go buduje. Kiedy masz wiele niezależnych zespołów, osobne serwisy pozwalają każdemu z nich wdrażać we własnym tempie. Masz jeden zespół? To nie masz problemu, który mikroserwisy rozwiązują.
Co zamiast? Modularny monolit w .NET
No dobrze, to co zamiast? Modularny monolit. Nuda, która zarabia.
Jak to wygląda. Jeden proces, jeden deploy, jedno repo. W środku moduły, np. Orders, Payments, Inventory i Users. Każdy moduł wystawia mały publiczny kontrakt, a całą resztę trzyma jako internal. Moduły rozmawiają ze sobą przez interfejsy i eventy in-process, czyli bez ani jednego wywołania sieciowego. Baza danych jest jedna, ale każdy moduł ma w niej własny schemat (orders, payments, inventory, users). I najlepsze: granic pilnuje kompilator, a nie sieć.
Struktura solucji. W .NET wygląda to mniej więcej tak (widok z Solution Explorera):
src/
 ├─ Bootstrapper/      /* jeden host ASP.NET Core */
 ├─ Modules/
 │   ├─ Orders/        /* Api / Application / Domain / Infrastructure */
 │   ├─ Payments/
 │   └─ Inventory/
 └─ Shared/            /* kontrakty i eventy między modułami */
W katalogu Modules każdy moduł to zestaw własnych projektów: Api, Application, Domain i Infrastructure. Bootstrapper to jeden host ASP.NET Core, który sam niczego nie robi - tylko składa moduły w jedną aplikację. Do tego malutki projekt Shared: same kontrakty i eventy, zero logiki. To ważne, bo jeśli w Shared zacznie lądować logika biznesowa, szybko zrobi się z niego śmietnik, przez który wszystkie moduły zaczną od siebie zależeć.
3 zasady, które robią całą różnicę
Sama struktura katalogów nie wystarczy. Modularny monolit działa dzięki 3 zasadom:
1. Mały publiczny kontrakt. Wszystko poza kontraktem jest internal, więc inne moduły fizycznie nie sięgną do środka. Kod, który spróbuje to zrobić, po prostu się nie skompiluje.
2. Zero cudzych tabel. Moduł nie dotyka DbContextu ani schematu innego modułu. Nigdy.
3. Komunikacja tylko przez kontrakt. Synchronicznie: przez interfejs. Asynchronicznie: przez event in-process.
W praktyce kontrakt i własny schemat modułu mogą wyglądać tak:
/* Shared - publiczny kontrakt modułu Inventory */
public interface IInventoryModule
{
    Task<bool> IsInStock(Guid productId, int quantity);
}

/* moduł Inventory - cała reszta jest internal */
internal sealed class InventoryDbContext : DbContext
{
    public InventoryDbContext(DbContextOptions<InventoryDbContext> options) : base(options) { }

    protected override void OnModelCreating(ModelBuilder modelBuilder)
    {
        modelBuilder.HasDefaultSchema("inventory"); /* własny schemat w tej samej bazie */
    }
}
Moduł Orders, który chce sprawdzić stan magazynu, wstrzykuje IInventoryModule i nic więcej o module Inventory nie wie. Nie widzi jego encji, nie widzi jego DbContextu, nie zna jego tabel. Dzięki temu kompilator pilnuje granic za darmo - code review nie musi tego robić.
Event między modułami zamiast brokera
A tu kod, który zastępuje całego brokera wiadomości. Moduł Orders publikuje zdarzenie OrderPlaced, a moduł Inventory ma handler, który na nie reaguje - w tym samym procesie:
/* Shared - kontrakt zdarzenia */
public record OrderPlaced(Guid OrderId, decimal Total);

/* moduł Orders - publikuje zdarzenie */
await _events.Publish(new OrderPlaced(order.Id, order.Total));

/* moduł Inventory - reaguje (ten sam proces, zero sieci) */
internal sealed class ReserveStockHandler : IEventHandler<OrderPlaced>
{
    public Task Handle(OrderPlaced e) => _stock.Reserve(e.OrderId);
}
IEventHandler<T> i _events to prosta abstrakcja szyny zdarzeń in-process: interfejs plus implementacja, która wywołuje handlery zarejestrowane w kontenerze DI.
To ten sam wzorzec co w mikroserwisach: publish, subscribe, luźne powiązanie. Orders nie wie, kto słucha jego zdarzeń, a Inventory nie wie nic o wnętrzu Orders. Tylko bez sieci, bez Kafki i bez rozproszonej sagi. A gdy kiedyś będziesz musiał wynieść moduł do osobnego serwisu, dokładasz transport i porządkujesz detale integracji.
Co dostajesz w zamian?
• Transakcje po prostu działają. BEGIN ... COMMIT obejmuje całą operację biznesową. Bez sag i kompensacji.
• Debugowanie to F5. Jeden proces, pełny stack trace i breakpoint dokładnie tam, gdzie chcesz.
• Jeden deploy, jeden pipeline. I jeden plik logów, kiedy w piątek o 15:59 coś się sypie :)
• Granice zmieniasz refactoringiem. Pomyliłeś się w podziale na moduły? Przesuwasz klasy, a nie przepinasz sieć. Poprawka to refactoring, a nie półroczny projekt migracyjny.
Ścieżka ewakuacji: jak później wyciąć mikroserwis z monolitu
I teraz najważniejsze: modularny monolit to nie ślepa uliczka. To ścieżka ewakuacji na wypadek, gdyby mikroserwisy jednak kiedyś okazały się potrzebne:
1. Budujesz modularny monolit z twardymi granicami od pierwszego dnia.
2. Któryś moduł zaczyna się realnie dusić - i widzisz to w metrykach, a nie w przeczuciach.
3. Wycinasz ten jeden moduł do osobnego serwisu. Kontrakt już istnieje, dokładasz tylko transport.
Wycięcie dobrze odseparowanego modułu może być kwestią tygodni. Rozplątywanie źle pociętych mikroserwisów potrafi trwać miesiącami albo latami.
Tania opcja vs opcja opłacona z góry. Można na to spojrzeć jak na opcje:
• dobry modularny monolit = tania opcja na mikroserwisy,
• mikroserwisy "na zapas" = opcja opłacona z góry.
A składkę roczną już znasz: prawie 3/4 miliona złotych.
Checklista: 5 pytań, zanim podpiszesz zgodę na mikroserwisy
Zanim ktokolwiek u Was podpisze zgodę na mikroserwisy, przejdźcie przez te 5 pytań:
1. Czy nasz problem jest w zespołach, czy w kodzie?
2. Które metryki pokazują, że coś wymaga osobnego skalowania?
3. Kto konkretnie będzie wstawał do awarii o 3:00 w nocy?
4. Ile to kosztuje rocznie - infrastruktura plus etaty plus podatek rozproszony?
5. Dlaczego modularny monolit nie wystarczy?
Brak dobrej odpowiedzi na choćby 1 pytanie to sygnał: jeszcze nie jesteście gotowi.
Ściąga: modularny monolit vs mikroserwisy
| Obszar | Modularny monolit | Mikroserwisy |
| Wywołanie między modułami | metoda lub event in-process, ok. 10 ns | wywołanie po sieci, ok. 10 ms + retry, timeout, circuit breaker, idempotencja |
| Transakcje | BEGIN ... COMMIT, wszystko albo nic | sagi, kompensacje, eventual consistency |
| Infrastruktura | jeden proces, jeden deploy, jeden pipeline | gateway, Kubernetes, service mesh, broker, tracing, logi, monitoring, CI/CD × liczba serwisów |
| Debugowanie | stack trace + F5, czasem 15 minut | correlation ID, logi z 6 serwisów, tracing, czasem 2 dni |
| Ludzie | zespół, który już masz | platform team, on-call 24/7, seniorzy od systemów rozproszonych, dojrzały DevOps |
| Zmiana granic | refactoring | projekt migracyjny |
| Koszt (8 programistów, ok. 10 serwisów) | punkt odniesienia | ok. 740 000 zł rocznie więcej |
| Kiedy wybrać | domyślnie | gdy spełniasz 4 na 4 warunki |
Podsumowanie
Mikroserwisy nie są złe - są drogie. Zbierzmy najważniejsze wnioski:
• Mikroserwisy to koszt organizacyjny. Płacisz nim za skalowanie zespołów, a nie za "lepszą architekturę".
• Rachunek jest wysoki. Sieć, transakcje, infrastruktura, debugowanie i ludzie to w przykładowej firmie z 8 programistami ok. 740 000 zł rocznie.
• Dowody są po stronie prostoty. Prime Video (-90% kosztów infrastruktury), Stack Overflow, Shopify, Segment i "MonolithFirst" Martina Fowlera.
• Domyślny wybór: modularny monolit. Twarde granice, internal, eventy in-process. Nuda, która zarabia.
• Serwisy wycinaj z dowodem w ręku. Metryki i realny ból, a nie moda i keynote z konferencji.
Jeśli ten tekst otworzył Ci oczy, wyślij go swojemu team leadowi albo CTO. Serio - ten jeden link może oszczędzić Waszej firmie kilkaset tysięcy złotych rocznie.
A jeśli chcesz więcej takich konkretów, dołącz do mojej społeczności. Jest nas tam już ponad 10 000 programistów .NET. Raz w tygodniu wysyłam jeden konkretny mail: najważniejsze newsy ze świata .NET i techniczne mięso, takie jak w tym artykule. Do tego rabaty na moje kursy, które zawsze najpierw trafiają właśnie do społeczności.
Wystarczy zostawić maila tutaj: modestprogrammer.pl/newsletter. Zero spamu - wypisujesz się jednym kliknięciem.