Sklep internetowy. 20 000 użytkowników dziennie. Procesor serwera pracuje na 97%, a lista zamówień w panelu obsługi ładuje się ponad 8 sekund. Na testach ta sama lista ładowała się w 0,3 sekundy. Szef ma na to proste rozwiązanie: "kupmy większy serwer". A większość programistów, zapytana o przyczynę, od razu wskazuje bazę danych - przecież to ona wykonuje zapytania. Zmierzyłem to. To nie baza.
W tym artykule pokażę Ci, jak sprawdzić, co w aplikacji naprawdę kończy się pierwsze, zanim wydasz pieniądze na mocniejszą maszynę. Przejdziemy przez zasoby, o których pamięta każdy, i te, o których prawie wszyscy zapominają. Poznasz metodę USE, zobaczysz, jak zmierzyć problem w .NET po obu stronach - w aplikacji (dotnet-counters) i w bazie (Query Store) - i dojdziemy do jednej linii kodu, która zajęła cały serwer. Na koniec wyjaśnię, dlaczego testy niczego nie wyłapały i w jakiej kolejności szukać wąskiego gardła we własnym systemie.
Całość pokażę na jednym przykładzie: sklepie internetowym Dioda, który sprzedaje elektronikę (słuchawki, konsole, laptopy) i który przygotowujemy na Black Friday. Firma i dane są fikcyjne, ale sklep działa - to repozytorium mojego kursu, napisane w .NET 10.
Stan danych: wrzesień 2026. Sklep działa na .NET 10 i SQL Server Express. Wyniki oznaczone jako "u mnie" (procesor, dotnet-counters, Query Store) to pomiary na moim komputerze - u Ciebie liczby będą inne, ale kierunek będzie ten sam.
Sklep Dioda: 2 lata temu i dziś
2 lata temu Dioda miała 1 000 użytkowników dziennie. W szczycie przychodziło około 5 żądań na sekundę, p95 czasu odpowiedzi wynosił 180 ms (czyli 95% żądań kończyło się szybciej), a procesor serwera pracował na 6%. Koszt: 90 zł miesięcznie.
Dziś użytkowników jest 20 razy więcej, a w szczycie przychodzi około 90 żądań na sekundę. p95 wynosi 8,2 sekundy, procesor - 97%. A koszt? Bez zmian, bo to wciąż ten sam serwer.
| Wskaźnik | 2 lata temu | Dziś |
| Użytkownicy dziennie | 1 000 | 20 000 |
| Żądania na sekundę w szczycie | ok. 5 | ok. 90 |
| p95 czasu odpowiedzi | 180 ms | 8,2 s |
| Procesor serwera | 6% | 97% |
| Koszt serwera | 90 zł miesięcznie | 90 zł miesięcznie |
Architektura jest prosta: użytkownicy, a za nimi 1 serwer, na którym działa zarówno aplikacja w ASP.NET Core, jak i baza SQL Server Express. Tak zaczyna wiele sklepów i przy 1 000 użytkowników to w zupełności wystarczało.
Dziś ten serwer nie nadąża. Najbardziej widać to w panelu obsługi: lista zamówień ładuje się 8 sekund. Klienci jeszcze jakoś kupują, ale pracownicy, którzy przez cały dzień obsługują zamówienia, czekają przy każdym kliknięciu.
Zanim kupisz większy serwer, sprawdź, co się kończy
Szef widzi, że sklep zwalnia, i proponuje najprostsze rozwiązanie: "Sklep zwalnia. Kupmy większy serwer?"
Zanim wydasz pieniądze, odpowiedz jednym zdaniem: "Najpierw sprawdźmy, co się kończy."
Większy serwer pomaga tylko wtedy, gdy brakuje tego, czego w nim jest więcej. Więcej rdzeni nic nie da, jeśli żądania stoją w kolejce po wolne połączenie do bazy. Więcej pamięci nie przyspieszy zewnętrznego API, które odpowiada wolno albo wcale. A szybszy dysk nie pomoże, jeśli zapytania czekają na siebie nawzajem przez blokady w bazie. Dlatego zanim cokolwiek dołożysz, musisz wiedzieć, który zasób jest wąskim gardłem.
Zasoby, o których się pamięta
Zacznij od zasobów, o których pamięta każdy:
• procesor,
• pamięć,
• dysk,
• sieć.
Te 4 widzisz w każdym panelu hostingu i właśnie na nie zwykle patrzymy w pierwszej kolejności. Problem w tym, że w systemach tej skali częściej kończy się coś zupełnie innego.
I te, o których się zapomina
Oto 4 zasoby, które kończą się po cichu:
• Pula połączeń do bazy. W .NET domyślnie 100 połączeń na proces (ustawienie Max Pool Size w SqlClient). Gdy wszystkie są zajęte, kolejne żądania czekają na wolne połączenie, a po przekroczeniu czasu kończą się błędem.
• Wątki w puli .NET. Blokuje je każde wywołanie .Result i .Wait() na zadaniach: wątek stoi i czeka, zamiast obsługiwać kolejne żądania. Pod obciążeniem takich czekających wątków robi się coraz więcej, aż pula przestaje nadążać.
• Zewnętrzne API. Płatności, SMS, kurier. Jeśli któryś z tych serwisów zwalnia, Twoja aplikacja zwalnia razem z nim.
• Blokady w bazie. Zapytania czekają na siebie nawzajem, bo jedno trzyma blokadę na danych, których potrzebuje drugie.
Żadnego z nich nie zobaczysz w panelu hostingu. Procesor może mieć spory zapas, pamięci może być pod dostatkiem, a aplikacja i tak będzie stała, bo wszystkie żądania czekają w kolejce po jedno z 100 połączeń.
Metoda USE: 3 pytania do każdego zasobu
Żeby niczego nie pominąć, użyj metody USE (opisał ją Brendan Gregg). To 3 pytania, które zadajesz po kolei każdemu zasobowi:
1. Utilization (zajętość) - jak bardzo zasób jest zajęty?
2. Saturation (nasycenie) - czy coś na niego czeka w kolejce?
3. Errors (błędy) - czy pojawiają się błędy?
Siła tej metody polega na tym, że działa dla każdego zasobu, nie tylko dla procesora i pamięci. Te same pytania zadajesz puli połączeń: ile połączeń jest zajętych, ile żądań czeka na wolne i ile kończy się błędem przekroczenia czasu. I tak samo zewnętrznemu API. Mała ściąga:
| Zasób | Zajętość (U) | Kolejka (S) | Błędy (E) |
| Procesor | ile procent czasu pracuje | ile wątków czeka na wolny rdzeń | rzadko spotykane |
| Pamięć | ile pamięci zajmuje proces | jak często i jak długo pracuje garbage collector | OutOfMemoryException |
| Pula połączeń do bazy | ile połączeń jest zajętych | ile żądań czeka na wolne połączenie | ile kończy się błędem przekroczenia czasu |
| Zewnętrzne API | ile wywołań trwa równocześnie | ile wywołań czeka na swoją kolej | ile kończy się błędem albo timeoutem |
Jeśli przy którymś zasobie odpowiedź na pytanie o kolejkę brzmi "tak, coś czeka", to bardzo możliwe, że właśnie znalazłeś wąskie gardło.
Kto bierze procesor: aplikacja czy baza?
Wróćmy do Diody. Procesor serwera pracuje na 97%. Kto go bierze - aplikacja czy baza? Zastanów się chwilę, zanim przeczytasz dalej.
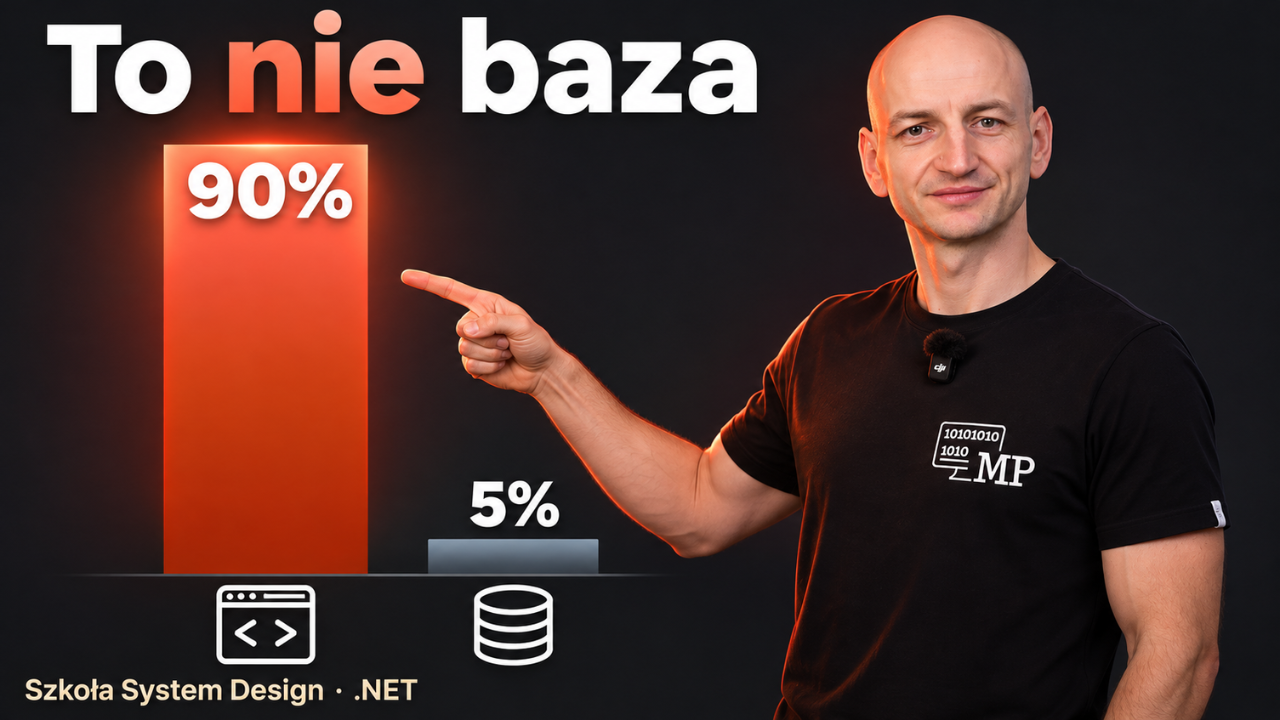
Większość programistów zgaduje, że baza. W końcu to ona wykonuje zapytania. Pomiar mówi jednak co innego: aplikacja bierze około 90% procesora, a SQL Server około 5%.
Sprawdziłem to też testem obciążenia na repozytorium sklepu. U mnie sklep brał od kilkunastu do ponad 70% procesora komputera, a baza od 2 do 13%. Skoro aplikacja i baza stoją na jednym serwerze, to aplikacja zjada procesor, który mógłby obsługiwać zapytania.
Skąd to wiadomo? Z pomiaru po obu stronach.
Pomiar w aplikacji: dotnet-counters
Po stronie aplikacji mierzysz narzędziem dotnet-counters. Instalujesz je jako globalne narzędzie .NET, a potem podłączasz się do działającego procesu po nazwie:
dotnet tool install -g dotnet-counters
dotnet-counters monitor -n Dioda.Shop
Zamiast Dioda.Shop wpisujesz nazwę swojego procesu. dotnet-counters na bieżąco pokazuje procesor, pamięć, odśmiecanie (GC) i pulę wątków. Poniżej wybrane wiersze wyniku po 2 minutach testu przy 80 żądaniach na sekundę (u mnie):
PS C:\Kurs\dioda> dotnet-counters monitor -n Dioda.Shop
    dotnet.gc.collections ({collection})
        …
        gen2                                  48
    dotnet.gc.heap.total_allocated (By)        1.1461e+11
    …
    dotnet.gc.pause.time (s)                  41.925
    …
    dotnet.process.cpu.time (s)
        …
        user                               1,168.563
    dotnet.process.memory.working_set (By)     7.561e+09
Co z tego wynika?
• dotnet.gc.heap.total_allocated: sklep zaalokował 115 GB pamięci w ok. 2 minuty, czyli prawie 1 GB na sekundę.
• gen2 i dotnet.gc.pause.time: garbage collector zrobił 48 pełnych przebiegów, a pauzy trwały łącznie 42 sekundy.
• dotnet.process.cpu.time: proces zużył prawie 1 200 sekund czasu procesora, czyli średnio prawie 10 rdzeni.
• dotnet.process.memory.working_set: proces zajmuje 7,5 GB pamięci.
Taki obraz to wyraźny sygnał: aplikacja tworzy gigantyczną liczbę obiektów, a procesor zajmuje się ich budowaniem i sprzątaniem po nich. Tylko jeszcze nie wiadomo, skąd te obiekty się biorą.
Pomiar w bazie: Query Store
Po stronie bazy patrzysz do Query Store. W SSMS znajdziesz go w drzewie bazy: Query Store → Top Resource Consuming Queries. Ten raport pokazuje zapytania, które zużywają najwięcej zasobów. Poniżej dane z 5-minutowego testu typowego ruchu na tym samym sklepie (u mnie):
| Zapytanie | Wykonania | Średnio | Procesor bazy |
| Lista zamówień w panelu | 143 | 12,0 s | 2,1 s |
| Wyszukiwarka | 1 670 | 385 ms | 31 ms |
| Polecane na stronie głównej | 1 181 | 3 ms | 2,8 ms |
Najcięższa jest lista zamówień: 143 wykonania, średnio 12 sekund. Dalej wyszukiwarka - kilkaset milisekund - i polecane produkty na stronie głównej, zaledwie 3 milisekundy.
Najważniejsze jest jednak to, na co lista czekała. Z 12 sekund aż 9,5 sekundy baza czeka na aplikację. Query Store nazywa to Network IO: baza wysłała wiersze i czeka, aż aplikacja je odbierze. Zwróć uwagę na kolumnę "Procesor bazy" - przy liście to tylko 2,1 sekundy. Baza wcale nie jest tu zapchana. Ona po prostu czeka, aż aplikacja przetrawi wszystko, co dostała.
Mierz po obu stronach: w aplikacji i w bazie
To najważniejsza lekcja z całej tej historii. Każdy z tych pomiarów osobno prowadzi na manowce:
• sam Query Store podpowiedziałby: wolne zapytanie, dołóż indeks,
• sam dotnet-counters: brakuje pamięci, dołóż serwer.
Dopiero razem widać prawdziwą przyczynę: aplikacja ściąga za dużo danych. Baza wysyła ogromną liczbę wierszy, aplikacja buduje z nich gigabajty obiektów, a garbage collector i procesor nie nadążają z resztą.
Przyczyna: jedna linia z ToList()
A to kod listy zamówień w panelu, z repozytorium sklepu (plik src/Dioda.Shop/Pages/Admin/Orders/Index.cshtml.cs, fragmenty pominięte oznaczyłem "…"):
var orders = db.Orders
    .Include(o => o.Lines)
    .Include(o => o.Customer)
    .ToList();
…
    orders = orders.Where(o => o.Status == status).ToList();
…
Orders = orders
    .OrderByDescending(o => o.CreatedAt)
    .Skip((PageNumber - 1) * PageSize)
    .Take(PageSize)
    .ToList();
Spójrz na czwartą linię: ToList(). W tym miejscu EF Core wysyła zapytanie do bazy i ściąga do pamięci wszystkie zamówienia, razem z pozycjami i klientami. Na produkcji to 150 000 zamówień.
Dopiero szósta linia filtruje je po statusie - już w pamięci. A ostatnie linie sortują je i przez Skip i Take wybierają w pamięci 50 zamówień do pokazania. Przy każdym wejściu na listę aplikacja buduje obiekty z całej tabeli tylko po to, żeby za chwilę wyrzucić prawie wszystkie. Stąd procesor, gigabajty pamięci i 9,5 sekundy, przez które baza czeka, aż aplikacja odbierze wiersze.
Ten kod wygląda niewinnie i przechodzi każde code review "na oko". Każda linia z osobna jest poprawna. Problem polega na tym, gdzie wykonuje się filtr i stronicowanie: w pamięci aplikacji zamiast w bazie.
Jak to naprawić. Kierunek jest prosty: filtr, sortowanie i stronicowanie ma wykonać baza. Wystarczy nie wywoływać ToList() na początku i budować zapytanie na IQueryable - wtedy EF Core przetłumaczy Where, OrderByDescending, Skip i Take na SQL i ściągnie z bazy tylko te 50 zamówień, które naprawdę pokazujesz. Mniej więcej tak:
IQueryable<Order> query = db.Orders
    .Include(o => o.Lines)
    .Include(o => o.Customer);
…
    query = query.Where(o => o.Status == status); /* filtr w bazie */
…
Orders = query
    .OrderByDescending(o => o.CreatedAt)
    .Skip((PageNumber - 1) * PageSize)
    .Take(PageSize)
    .ToList(); /* dopiero tu zapytanie trafia do bazy */
Liczbę stron też policz w bazie (Count na tym samym zapytaniu), a nie na liście w pamięci. Do tego dochodzi indeks pod filtr i sortowanie, żeby baza nie musiała za każdym razem przeglądać całej tabeli. U mnie po takiej naprawie lista przyspieszyła z sekund do milisekund.
Dlaczego testy niczego nie wyłapały?
Najgorsze w tej historii jest to, że przed wdrożeniem wszystko było sprawdzone.
Na testach baza ma 3 000 zamówień, a lista ładuje się w 0,3 sekundy. Na produkcji jest 150 000 zamówień: ta sama lista, ten sam kod, a ładowanie trwa 8,2 sekundy. I codziennie przybywa 200 nowych zamówień.
| Wskaźnik | Testy | Produkcja |
| Zamówienia w bazie | 3 000 | 150 000 (+200 dziennie) |
| Czas ładowania listy | 0,3 s | 8,2 s |
To 50 razy więcej danych na produkcji niż na testach. Przy 3 000 zamówień ściągnięcie całej tabeli do pamięci przechodzi niezauważone. Przy 150 000 kosztuje 8 sekund przy każdym wejściu na listę. Błąd siedział w kodzie od pierwszego dnia - po prostu na małej bazie nie miał szansy się ujawnić.
Wniosek jest prosty: test wydajności ma sens tylko na danych w skali produkcji. Przy 50 razy mniejszej bazie takiego problemu po prostu nie widać, choćbyś testował bardzo starannie.
Z mojego doświadczenia: "na testach wszystko działało"
Od lat budujemy w FindSolution aplikacje dla firm. I jeden telefon słyszę częściej niż inne:
"Na testach wszystko działało, a dziś, w dniu kampanii, system stoi."
Przyczyny są prawie zawsze podobne:
• kilka ciężkich zapytań,
• maile wysyłane w środku składania zamówienia,
• wywołanie zewnętrznego API bez timeoutu.
I prawie zawsze dało się to policzyć tydzień wcześniej. Nie trzeba zgadywać, co padnie w dniu kampanii - wystarczy zmierzyć, zanim ruch przyjdzie.
W jakiej kolejności szukać wąskiego gardła
W systemach tej skali problemy pojawiają się zwykle w takiej kolejności:
1. Zapytania do bazy: brak indeksu, za dużo danych, zapytania w pętli (jedno zapytanie na każdy element listy zamiast jednego na całą listę).
2. Zewnętrzne API bez limitu czasu. Jeśli usługa płatności czy kuriera zwalnia, a Ty nie ustawiłeś timeoutu, Twoje żądania czekają razem z nią. Domyślny timeout HttpClient w .NET to aż 100 sekund.
3. Pula połączeń i wątków, wyczerpana przez jedno albo drugie. Wolne zapytania i wolne API trzymają połączenia i wątki, aż w końcu zabraknie ich dla wszystkich pozostałych żądań.
4. Procesor aplikacji. Kończy się zwykle na końcu. Chyba że aplikacja robi pracę bazy - tak jak Dioda, która filtruje i stronicuje 150 000 zamówień w pamięci.
Dlatego szukaj w tej kolejności. I przy każdym kroku zadawaj 3 pytania z metody USE.
Większy serwer czy naprawa zapytania?
Teraz możesz wrócić do szefa z odpowiedzią opartą na pomiarze.
Większy serwer kupuje trochę czasu. Ale zamówień przybywa 200 dziennie, więc lista i tak będzie coraz wolniejsza - z każdym dniem kod ściąga do pamięci więcej danych. Do tego płacisz więcej co miesiąc, a problem zostaje w kodzie.
Naprawa zapytania zdejmuje obciążenie od razu: filtr i stronicowanie w bazie, a do tego indeks. U mnie lista przyspieszyła z sekund do milisekund, a procesor przestał być zajęty budowaniem obiektów, których nikt nie ogląda.
W przypadku Diody wybór jest oczywisty. Ale zwróć uwagę, że znamy go dopiero dzięki pomiarowi. Bez niego obie opcje wyglądały równie sensownie.
Pułapka: nie optymalizuj na ślepo
I zasada na koniec: nie optymalizuj na ślepo. Kolejność jest zawsze taka sama:
1. Pomiar.
2. Jedna zmiana.
3. Znowu pomiar - tym samym testem.
Jeśli zmienisz 3 rzeczy naraz, nie dowiesz się, która pomogła, a która zaszkodziła. A może się zdarzyć, że jedna poprawka mocno przyspieszyła aplikację, a druga po cichu zabrała część tego zysku. Tylko pomiar po każdej pojedynczej zmianie daje Ci pewność, co naprawdę działa.
Podsumowanie
Tak szukasz wąskiego gardła: najpierw sprawdzasz, co się kończy, i mierzysz po obu stronach. Dopiero potem kupujesz serwer. Albo, tak jak w Diodzie, wcale go nie kupujesz, bo winna jest jedna linia kodu. Zapamiętaj 3 rzeczy:
1. Zanim coś dołożysz, sprawdź, co się kończy. Procesor, pamięć, dysk i sieć - ale też pula połączeń, wątki, zewnętrzne API i blokady w bazie. Do każdego zasobu zadaj 3 pytania z metody USE.
2. Mierz po obu stronach: w aplikacji (dotnet-counters) i w bazie (Query Store). Osobno oba pomiary prowadzą do złych wniosków.
3. Testuj na danych w skali produkcji. Przy 50 razy mniejszej bazie tego problemu po prostu nie widać.
A jeśli chcesz przejść całą tę drogę krok po kroku, na działającym sklepie, zapraszam Cię do mojego kursu Szkoła System Design. To ponad 20 godzin nauki: 12 modułów, 7 laboratoriów na sklepie Dioda w .NET 10 i 11 zadań projektowych z omówieniami. Zaczynamy od wymagań i szacowania ruchu, a potem przechodzimy przez bazę danych, cache, kolejki i odporność na awarie, aż po architekturę i rozmowę system design na seniora. Naprawę listy zamówień z tego artykułu robisz tam w laboratorium, na tym samym sklepie.
Szczegóły znajdziesz tutaj: modestprogrammer.pl/szkola-system-design. Zapisy otwieram tylko na tydzień - jeśli akurat są zamknięte, zostaw tam e-mail na liście oczekujących, a dam Ci znać o następnej edycji.
A co padło pierwsze w Twoim systemie, gdy urósł ruch? Jeśli jeszcze nie wiesz - teraz wiesz, jak to sprawdzić :)